






fail_timeout调优核心是匹配网络实际行为、连接空闲特性与keepalive机制;在Nginx Ingress等场景中定义“封禁期”,需≥网络异常持续时间+探测恢复时间,并配合Calico配置、NetworkPolicy及externalTrafficPolicy等网络层加固。
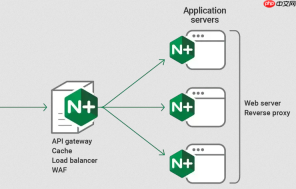
fail_timeout 的调优核心不是单纯设大或设小,而是让其与底层网络实际行为、连接空闲特性以及上层组件的 keepalive 机制形成匹配。在极端网络(如高丢包、长抖动、中间设备强制断连)下频繁误摘,本质是健康检查探测失败与真实服务不可用之间出现了误判。
理解 fail_timeout 在哪起作用
fail_timeout 主要出现在两类场景中:
- 反向代理层(如 Nginx Ingress Controller):定义后端 Pod 被标记为“不可用”后,需等待多久才重新尝试探测;它不决定探测频率,而是决定“封禁期”长度。
- 某些 Service Mesh 控制面(如早期 Istio Pilot 配置)或自定义健康检查器:作为故障隔离窗口参数,影响熔断恢复节奏。
注意:Kubernetes 原生 readinessProbe / livenessProbe 中没有叫 fail_timeout 的字段,它的语义常被误用于描述 probe 失败后的“拒绝服务时长”,实际应关注 failureThreshold × periodSeconds 这一隐式窗口。
避免误摘的关键配比逻辑
真正防止误摘,需要让 fail_timeout ≥ 网络异常持续时间 + 探测恢复所需时间。否则,刚恢复就又被踢出,形成震荡。
- 先确认你使用的组件是否真支持 fail_timeout(例如 Nginx Ingress 的 upstream 配置中:
fail_timeout=30s),并查清其单位和触发条件。 - 测量典型网络抖动窗口:用 tcpdump 或 conntrack 观察 TCP 连接在极端条件下最长中断多久仍能自动续传(常见于 ALB/NLB 的 4 分钟空闲超时,或云防火墙的 90 秒连接老化)。
- 同步配置 TCP keepalive:Pod 内应用需启用 keepalive(如 net.ipv4.tcp_keepalive_time=600),且间隔必须小于中间设备超时(建议设为超时值的 1/3~1/2)。
- 让 fail_timeout 至少覆盖 2~3 次连续探测失败周期:例如探测间隔 5s、失败阈值 3,则基础失败窗口是 15s;fail_timeout 建议设为 30–60s,留出网络恢复缓冲。
配合网络插件与策略加固
单靠调大 fail_timeout 不治本,需叠加网络层保障:
- 若使用 Calico,关闭 node-to-node mesh(
nodeToNodeMeshEnabled: false),改用 IPIP 或 VXLAN CrossSubnet 模式,减少跨节点路径跳数与丢包概率。 - 启用 NetworkPolicy 限制非必要流量,降低 conntrack 表压力——表满会导致新建连接被 DROP,引发假性超时。
- 对关键 Service,设置
externalTrafficPolicy: Local,避免经 iptables SNAT 后丢失客户端源 IP 和连接状态。
验证与观测建议
调优后必须通过真实压测验证,而非仅看指标:
- 用
iptables -t raw -A OUTPUT -p tcp --dport 80 -m statistic --mode random --probability 0.05 -j DROP模拟 5% 出向丢包,观察服务是否持续可用、Ingress 日志是否出现反复 up/down 记录。 - 检查 kube-proxy 日志中的
Stale endpoint或Endpoint not ready频次,结合kubectl get endpoints查看 endpoints 状态抖动周期。 - 在 Pod 内运行
ss -ti,确认 ESTABLISHED 连接的keepalive计时器是否按预期重置,而非卡在 FIN_WAIT 或 CLOSE_WAIT。


