






fail_timeout是故障节点的隔离冷却期参数,定义节点被标记失败后Nginx跳过其负载均衡的时间;需配合主动健康检查、合理时长(20–40秒)及禁用非幂等重试,才能有效阻断雪崩。
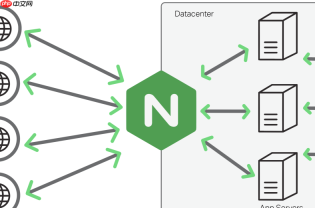
fail_timeout 不是时间窗口限流算法,而是一个故障节点“隔离冷却期”的配置参数。它本身不直接规避滚雪球式雪崩,但配合健康检查与重试控制,在 upstream 层面能有效切断故障传播链,防止一次超时演变成多次无效转发——这才是规避雪崩的关键动作。
下面从原理、误用风险和实操要点三方面说清楚怎么用好它:
fail_timeout 的真实作用:给故障节点“冷静期”,不是给请求限流
它定义的是:当一个 upstream 节点被标记为 failed(比如健康检查失败或 proxy_next_upstream 触发)后,Nginx 在多长时间内不再把新请求发给它。
- 例如
max_fails=2 fail_timeout=30s:该节点连续失败 2 次后,接下来 30 秒内彻底不参与负载均衡。 - 这 30 秒不是“等待它恢复”,而是强制跳过它、避免压测式重试、留出诊断和自愈时间。
常见误用:设太长 or 太短,反而放大雪崩
- 设太长(如 120s):节点已彻底宕机,Nginx 还在每 30 秒尝试一次健康检查,期间所有流量仍可能被轮询到它(尤其没配 least_conn 或健康检查时),等于持续制造超时。
- 设太短(如 5s):偶发网络抖动就触发隔离,又很快放行,造成节点反复进出,请求在“可用→失败→再可用”间震荡,加重上游不稳定。
正确配置组合:让 fail_timeout 发挥雪崩阻断力
-
搭配主动健康检查:仅靠
proxy_next_upstream被动失败判定太迟。必须加:health_check interval=3 fails=2 passes=2; check_http_expect_alive 2xx 3xx;
这样
fail_timeout才有前置依据——不是等第一个用户请求超时才开始计时,而是巡检发现异常后立即启动隔离。 -
fail_timeout 值建议取 20–40 秒:
- 足够覆盖一次 GC 停顿、慢 SQL 回滚或临时资源争抢的恢复窗口;
- 又不会让故障节点“隐身太久”,影响集群整体吞吐。
-
必须禁用非幂等操作的重试:
-
proxy_next_upstream_tries 1; -
proxy_next_upstream error timeout http_502 http_503 http_504; - 删掉
http_500和所有4xx——业务错误重试只会复制脏数据,不是救火,是纵火。
-
-
验证是否生效:
- 故意停掉一台后端;
- 查 access_log 中
$upstream_addr字段,确认 30 秒内该地址完全消失; - 同时观察
$upstream_response_time,应无持续 >proxy_read_timeout的记录。
本质上,fail_timeout 是 Nginx 对后端的一次“信任冻结”。它不解决超时本身,但让超时不再成为雪崩的导火索——因为系统学会了:不把压力重复砸向已经冒烟的节点。


