





5月28日,英伟达(nvidia)研究团队正式对外开源了名为 polar 的强化学习训练框架。该框架的关键突破在于:它支持 codex、claude code、qwen code 等当前主流代码智能体(agent)在完全无需改动原始代码的前提下,直接接入 grpo(广义相对策略优化)强化学习训练流程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
一、行业难题:智能体强化学习的“高墙”
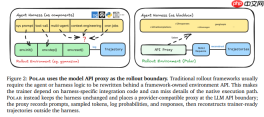
随着代码智能体从基础单步任务逐步演进至复杂长周期任务(例如跨仓库代码重构、操作系统级交互),开发者越来越依赖成熟稳定的执行框架(Harness)。但将这类结构复杂的框架对接传统强化学习基础设施时,却遭遇严峻挑战:
- 接入门槛极高: 传统方案强制要求将原有逻辑重构成标准环境接口(如 env.init()、env.step()),开发工作量大且易出错;
- 关键信息损耗: 在适配过程中,常丢失工具调用链路、多轮对话历史、子智能体协同机制等核心上下文,致使模型难以获得高质量反馈信号。
二、创新路径:以“API 边界”为训练起点
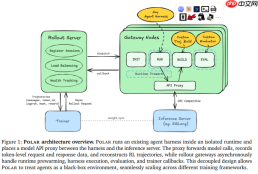
Polar 并未选择改造底层执行框架,而是另辟蹊径——把“模型 API 调用边界”作为强化学习训练的天然入口。
- 黑盒兼容设计: Polar 在代码执行框架与模型推理服务之间部署一个轻量透明代理(Gateway),无论智能体调用的是 Anthropic、OpenAI 还是 Google 的 API,均可无感拦截与转发请求;
- 轨迹动态构建: 在请求流转过程中,Polar 实时捕获 prompt、采样 token、logits 概率等关键数据,并自动组装成强化学习所需的完整行为轨迹(trajectory);
- 高性能异步架构: 系统采用 Rollout Server 统筹任务调度与数据持久化,Gateway Node 负责生命周期管理与资源释放;借助预热缓冲池(READY buffer)与并发处理能力,显著缓解长尾任务对 GPU 计算资源的阻塞效应。
三、实测效果:编码智能体性能跃升
实验结果表明,Polar 结合 GRPO 训练策略,在多个主流代码框架上均实现显著性能提升:

-
SWE-Bench Verified 基准测试: 同一 Qwen3.5-4B 底座模型在不同框架下的表现如下:
- Codex 框架: pass@1 分数由 3.8% 大幅跃升至 26.4%,增幅达 594.74%;
- Claude Code 框架: 从 29.8% 提升至 34.6%;
- Pi 框架: 由 34.2% 上升至 40.4%。
训练效率跃进: 引入 prefix_merging 优化后,相较传统 per_request 方式,整体训练耗时缩短约 5.39 倍,GPU 利用率则从 20.4% 提升至 87.7%。
行业观察
英伟达此次开源 Polar,本质上是在“AI 智能体”领域打通了一条通往强化学习训练的“高速通路”。它不仅赋能研究人员便捷复用海量开源代码框架开展高效训练,更通过系统级架构创新大幅降低了 GPU 算力使用门槛。
随着 Polar 的广泛应用,开发者将不再纠结于“如何让模型适配训练体系”,AI 编码智能体的进化路径也将愈发标准化与工程化。这标志着 AI 智能体训练正加速从实验室阶段的手动调参,迈向可规模化复制、高可靠交付的工业化生产新纪元。
论文地址:https://www.php.cn/link/01705df5db71738be54c3a7969eb8390


