





hadoop源码编译过程中集成snappy压缩功能的完整操作指南
1、 提前整理好全部依赖资源
2、 确保CentOS系统已接入互联网
3、 CentOS操作系统已完成外网配置,Linux虚拟机网络连通性良好,可稳定执行ping测试。
4、 全程使用root账户进行编译操作,防止因权限不足导致目录或文件访问异常。
5、 提前准备好Hadoop源码包、JDK 8、Maven构建工具以及Protobuf所需的jar依赖。
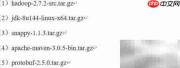
6、 安装对应版本的两个核心jar依赖包
7、 所有步骤均须在root用户权限下完成。
8、 解压JDK安装包,正确配置JAVA_HOME与PATH环境变量,并运行java -version命令验证环境是否配置成功。
9、 解压Maven安装包,设置MAVEN_HOME环境变量,并将其bin目录追加至PATH中。
10、 启动Hadoop源码编译流程
11、 构建完整的编译基础环境
12、 编译并部署Snappy本地压缩库
13、 编译并安装Protobuf编译工具(protoc)
14、 编译Hadoop本地原生库(native libraries),以增强I/O性能及Snappy等压缩算法的兼容支持。
15、 编译成功后,将在/opt/software/hadoop-2.7.2-src/hadoop-dist/target/路径下生成适配Snappy压缩的新版二进制发行包,文件名为hadoop-2.7.2.tar.gz,可直接用于集群部署与上线运行。


