





方舟coding plan续费前需评估档位性价比:一、确认5小时滚动额度(lite约1200次、pro约6000次);二、实测单prompt调用均值,反推等效prompt容量;三、高峰时段限流致lite实际额度折损超30%;四、lite不支持deepseek-v3.2等高阶模型,降低开发效率;五、若月内≥8日峰值超1200次,则pro为刚性需求。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
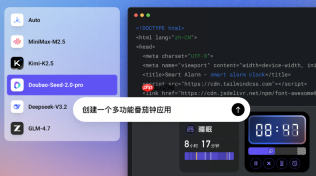
如果您正在使用火山引擎方舟 Coding Plan,且临近续费节点,则需注意其档位结构、额度重置机制与实际消耗特征可能显著影响长期使用成本。以下是针对方舟当前在售套餐的性价比分析步骤:
一、厘清方舟当前档位与计量方式
火山方舟采用5小时滚动额度制,不设周/月总限额,但每5小时重置一次调用次数。Lite与Pro档均以API请求次数为计量单位(1次用户Prompt ≈ 5–30次后台模型调用),非Prompt或Token计费。该机制直接影响高强度连续使用的稳定性。
1、访问方舟控制台,进入「Billing & Usage」页面。
2、点击「Coding Plan」子菜单,查看当前订阅状态与历史用量曲线。
3、确认所用档位下方明确标注的“每5小时额度”数值(如Lite约1,200次、Pro约6,000次)。
4、检查用量详情页中「Last 5 Hours」与「Rolling Window」标签,验证是否按滚动周期而非固定整点重置。
二、对比Lite与Pro档位的实际单位成本
方舟Lite档月费40元(首月8.9元),Pro档200元(首月44.9元),二者额度比为1:5,但需结合模型调用密度与任务复杂度判断真实效能落差。例如,启用Auto智能选模或调用DeepSeek-V3.2等高消耗模型时,单次Prompt可能触发近30次API请求,导致Lite档5小时内迅速耗尽。
1、在控制台「Model Selection」中切换至Auto模式,执行3次相同代码补全任务。
2、记录每次任务后「API Calls Used」增量值,计算平均单Prompt消耗量。
3、将该均值乘以Lite档1,200次额度,反推其等效Prompt容量(通常为40–240次)。
4、对Pro档重复相同测试,对比两档位在同等任务下的可持续使用时长差异。
三、识别隐性成本:限流与超售风险
方舟存在高峰期429限流现象,尤其在工作日10:00–12:00及14:00–16:00区间。该问题在Lite档更为突出,因其共享资源池优先级低于Pro档。若您的开发节奏集中于上述时段,Lite档实际可用额度可能低于标称值30%以上。
1、使用curl命令在高峰时段发起10次空Prompt请求(如发送“hello”)。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
2、统计返回HTTP状态码为429的比例。
3、登录方舟服务健康看板(status.feishu.cn/ark),核查当日「Throttling Rate」实时曲线。
4、对比非高峰时段相同测试结果,量化限流对有效额度的折损率。
四、评估模型兼容性带来的间接成本
方舟Pro档默认解锁全部模型(Doubao-Seed-Code、DeepSeek-V3.2、GLM-4.7、Kimi-K2.5),而Lite档仅开放Doubao-Seed-Code与基础GLM-4.7。当您依赖DeepSeek-V3.2处理Python异步逻辑或Kimi-K2.5解析UI截图时,Lite档将强制降级至低效模型,导致反复调试、重试增多,变相抬高时间成本与心理损耗。
1、在Lite档下上传一张含React组件结构的UI截图。
2、发起“生成对应JSX代码”指令,记录首次响应质量与修正轮次。
3、切换至Pro档,复现相同操作,对比代码完整性、Props命名规范性及事件绑定准确率。
4、统计两次任务从发起至可运行代码产出的总耗时差值。
五、核算续费决策临界点
若过去30天内,您有≥8个自然日出现5小时内额度耗尽,或单日平均调用密度持续高于1,000次/5小时,则Lite档已逼近性能瓶颈。此时Pro档的边际成本增量(+160元/月)将被节省的调试时间、避免的中断损失与提升的交付确定性所覆盖。
1、导出控制台「Usage History」CSV数据,筛选日期列与「Calls Per 5h」列。
2、对每日最大5小时调用量排序,取前8位数值。
3、计算该8日中,有多少日的峰值>1,200次(Lite档上限)。
4、若数量≥8,标记为「Pro档刚性需求」;若数量为5–7,建议启用Pro档试用期(首月44.9元)实测两周。


