





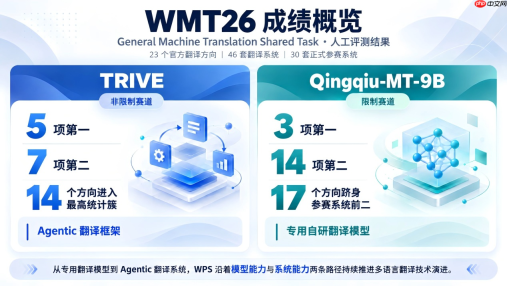
近日,金山办公翻译算法团队的两项技术成果在国际机器翻译评测wmt26中斩获优异成绩:多智能体翻译系统trive在23个语言方向中,有14个进入全球第一梯队;英语译繁体中文方向以80.5分遥遥领先,高居榜首,比第二名高出6.2分,部分语向的译文质量已超越专业人工译员。另一款专用翻译模型qingqiu-mt-9b则在参数量低于20b的限定赛道中总体排名第二。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
评测升级:翻译不仅要准确,更要响应指令
WMT由国际计算语言学学会(ACL)主办,已连续举办二十余年,被业界誉为机器翻译领域的“奥运会”。本届通用机器翻译任务覆盖23个语言方向,共46套系统参与人工评估,其中30套来自各参赛团队,其余16套包括谷歌翻译、GPT 5.5、DeepSeek V4 Pro等主流大模型及商业翻译服务,均由主办方统一纳入横向对比。
相较往届,WMT26显著加强了对“指令遵循能力”的考核。除基础语义准确性外,系统还需精准处理语气风格、领域术语,以及HTML、JSON等结构化文本格式要求。评测方法上,主办方采用对比式人工错误标注与动态抽样机制,全面衡量各系统在不同语言对上的综合表现。
简言之,今年的评测不仅关注“是否翻得准”,更强调“能否按用户意图翻”。
两条技术路径:TRIVE重构流程,青丘深耕模型
在英语译繁体中文方向,TRIVE以80.5分位列第一,第二名为74.3分,而第二至第四名之间仅相差0.3分,竞争极为激烈。
评测中一道典型口语题为:“下次你敲门,得等我说‘进来’你才能进来”,TRIVE输出译文获得95分高分,完整保留了原句含义、对话语气及人物互动关系。

TRIVE采用类“翻译项目组”的协同工作流:三位“译员”分别聚焦于忠实性、流畅性与创造性表达;“主编”整合三稿形成初版;“审校”模块则负责核查术语一致性、语气适配性、段落换行及HTML标签等格式规范,并自动触发修正。该流程与底层大模型完全解耦,无需额外微调即可灵活适配多种基座模型。
另一自主研发模型Qingqiu-MT-9B基于Qwen3.5-9B构建。未经翻译专项训练的原始基座模型,在跨语言方向上的平均排名为41.5;经金山办公针对性优化后,平均名次跃升至16.5,在参数量≤20B的受限赛道中整体位居第二。
团队在维持9B参数规模的前提下,显著提升了模型的翻译能力。更小的模型体积也降低了推理开销与部署复杂度,更好地兼顾实际业务场景中对质量与成本的双重需求。
从技术研发到产品落地:相关能力已全面接入WPS翻译功能
一家深耕中文办公软件三十余年的企业,做好翻译并非偶然。中文是歧义密度最高的语言之一,而机器翻译的核心挑战,正是从上下文中精准识别真实语义意图——这恰是WPS长期处理海量中文文档所积累的核心能力。
这套经WMT26权威验证的翻译技术已投入实际应用:公开信息显示,WPS全文翻译、划词翻译、词霸翻译以及面向海外用户的AnyDoc翻译,均已集成与Qingqiu-MT-9B同源的翻译模型;TRIVE所采用的多策略融合与闭环校验机制,也将陆续应用于WPS企业级全文翻译、海外本地化全文翻译及协作IM实时翻译等关键场景。


