可在政府、金融、电信、零售、互联网、电子商务及医疗等行业,从事数据处理、分析建模与深度挖掘等相关岗位工作。
1、 熟练掌握SQL语言,具备连接企业级数据库的能力,能依据具体业务场景,从海量数据中精准提取有效信息,并开展多角度建模与分析;可输出结构合理、逻辑严密的数据分析报告,完整覆盖数据采集、清洗、建模、验证到结果呈现的全流程;理解关系型数据库与非关系型数据库的核心差异,熟练进行数据的增、删、改、查操作,掌握子查询、连接查询、窗口函数等高级语法,具备数据库综合设计与应用能力。
2、 实战导向的大数据挖掘算法课程,系统涵盖Apriori关联规则挖掘、Tanagra可视化分析平台及决策树等主流技术,全面解析数据挖掘方法论。所谓“深入”,一方面从底层原理切入,透彻掌握经典算法的数学基础与执行逻辑,准确判断各类算法在不同业务场景中的适用边界;另一方面注重抽象思维训练,引导学习者提炼算法背后的设计范式,并迁移应用于新问题的解决过程;真正实现理论内化与工程实践的融合。所谓“浅出”,则聚焦技术落地:其一,依托SQL Server和Excel等普及型工具快速构建挖掘流程,大幅降低初学者门槛;其二,通过Weka等主流开源平台,在真实数据集上实操算法部署、参数调优与效果评估;其三,使用Java与C语言逐行编码复现核心算法,强化对算法本质的理解与动手实现能力。课程兼顾学术严谨性与工程实用性,助力学员从零构建完整的数据挖掘知识框架,切实提升面向业务分析、智能系统开发与辅助决策等多场景的问题解决能力。
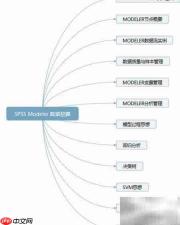
3、 SPSS Modeler数据挖掘实战:深度融合统计学理论与工业级挖掘技术,系统掌握变量维度管理、数据预处理、建模分析及数据流编排等核心功能模块;深入理解各节点参数的实际含义与影响机制,熟练运用参数配置策略与组合方案,显著提升建模效率与结果可靠性。
4、 精通Python网络爬虫开发体系,熟练使用Requests、BeautifulSoup、lxml等基础库完成网页内容抓取;深入掌握Scrapy框架的整体架构与异步流式开发模式,能够独立完成项目初始化、Spider编写、Pipeline定制及中间件扩展;灵活调用Scrapy-Redis、Downloader Middleware、Item Exporter等增强组件,显著提升分布式采集能力与运行稳定性;具备Scrapy与MySQL数据库的无缝对接能力,实现采集数据的自动入库、去重与结构化管理;全面覆盖主流爬虫工具链的工程化应用,具备端到端的数据采集、清洗、存储与初步分析能力。
5、 系统研习机器学习核心知识体系,涵盖Python编程基础、主流算法原理及Numpy、Pandas、Matplotlib、Seaborn等关键科学计算与可视化库。重点掌握监督学习与无监督学习两大范式:其中监督学习进一步细分为分类(如逻辑回归、SVM)与回归(如线性回归、岭回归)任务;所有内容均围绕实际应用场景展开,强调算法理解与代码实现并重,夯实数据建模与工程落地双重能力。
6、 掌握机器学习关键技术栈:深刻理解线性回归的假设前提与评估指标,熟练构建并优化决策树与支持向量机模型,精通K-Means、DBSCAN等聚类方法及朴素贝叶斯分类器,熟悉EM算法迭代思想、隐马尔可夫模型(HMM)的状态序列建模能力、LDA主题建模原理,以及其它常用机器学习模型的应用场景与调参技巧。