大型视觉语言模型(lvlm)可以通过扩展模型来提高性能。然而,扩大参数规模会增加训练和推理成本,因为每个token的计算都会激活所有模型参数。
来自北京大学、中山大学等机构的研究者联合提出了一种新的训练策略,名为MoE-Tuning,用于解决多模态学习和模型稀疏性相关的性能下降问题。MoE-Tuning能够构建参数数量惊人但计算成本恒定的稀疏模型。此外,研究者还提出了一种基于MoE的新型稀疏LVLM架构,称为MoE-LLaVA框架。在这个框架中,通过路由算法仅激活前k个专家,其余专家保持非活动状态。通过这种方式,MoE-LLaVA框架在部署过程中能够更加高效地利用专家网络的资源。这些研究成果为解决LVLM模型在多模态学习和模型稀疏性方面的挑战提供了新的解决方案。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文地址:https://arxiv.org/abs/2401.15947
项目地址:https://github.com/PKU-YuanGroup/MoE-LLaVA
Demo地址:https://huggingface.co/spaces/LanguageBind/MoE-LLaVA
论文题目:MoE-LLaVA: Mixture of Experts for Large Vision-Language Models
MoE-LLaVA 只有 3B 个稀疏激活参数,表现却与 LLaVA-1.5-7B 在各种视觉理解数据集上相当,甚至在物体幻觉基准测试中甚至超越了 LLaVA-1.5-13B。通过 MoE-LLaVA,该研究旨在建立稀疏 LVLMs 的基准,并为未来研究开发更高效和有效的多模态学习系统提供宝贵的见解。MoE-LLaVA 团队已经开放了所有的数据、代码和模型。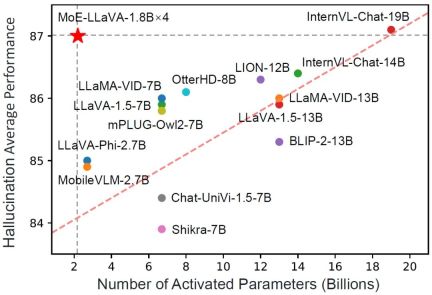
图 1 MoE-LLaVA 在幻觉性能上和其他 LVLM 的比较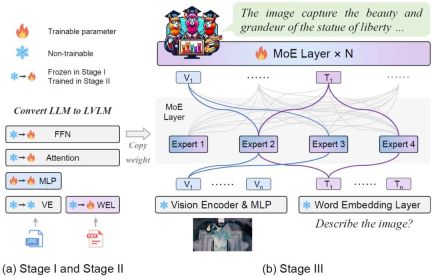

Analyze Video By Qwen Free
Qwen 视频智能分析基础客户端(免费版),基于 Qwen 3.5 Plus 多模态模型对本地视频进行内容分析,支持场景描述与基础内容理解,采用默认抽帧频率和提示词,适合快速概览视频,API Key 读取自 ~/.skill-platform/skill-platform.json 的 skills 配置。
下载
如图 2 所示,视觉编码器(vision encoder)处理输入图片得到视觉 token 序列。利用一个投影层将视觉 token 映射成 LLM 可接受的维度。类似地,与图片配对的文本经过一个词嵌入层(word embedding layer)被投影得到序列文本 token。阶段 1:如图 2 所示,阶段 1 的目标是让视觉 token 适应到 LLM,赋予 LLM 看懂图片的实体有哪些的能力。MoE-LLaVA 采用一个 MLP 来将图片 token 投影到 LLM 的输入域,这意味着一个个图片小 patch 被 LLM 当作伪文本 token。在这个阶段,LLM 被训练学会描述图片,理解更高层次的图片语义。在这个阶段 MoE 层不会被应用到 LVLM 中。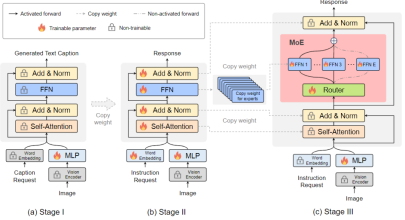
阶段 2:用多模态的指令数据来微调是提高大模型能力和可控性的关键技术,并且在这个阶段 LLM 被调整为有多模态理解能力的 LVLM。在这个阶段该研究加入更复杂的指令,包含图片逻辑推理,文字识别等高级任务,要求模型有更强的多模态理解能力。通常来说,稠密模型的 LVLM 到此就训练完成,然而研究团队发现同时将 LLM 转为 LVLM 和把模型稀疏化是具有挑战的。因此,MoE-LLaVA 将使用第二阶段的权重作为第三阶段的初始化以降低稀疏模型学习的难度。阶段 3:MoE-LLaVA 将 FFN 复制多份作为专家集合的初始化权重。当视觉 token 和文本 token 被喂入 MoE 层时,router 会计算每一个 token 和专家们的匹配权重,然后每个 token 会被送入最匹配的 top-k 个专家进行处理,最后根据 router 的权重加权求和汇聚成输出。当 top-k 个专家被激活时,其余的专家保持非活动状态,这种模型构成了具有无限可能的稀疏通路的 MoE-LLaVA。如图 4 所示,由于 MoE-LLaVA 是第一个基于 LVLM 搭载 soft router 的稀疏模型,因此该研究将之前的模型归纳为稠密模型。研究团队在 5 个图片问答 benchmark 上验证了 MoE-LLaVA 的性能,并报告了激活的参数量和图片分辨率。与 SOTA 方法 LLaVA-1.5 相比,MoE-LLaVA-2.7B×4 展现了强大的图片理解能力,在 5 个 benchmark 上性能非常接近 LLaVA-1.5。其中 MoE-LLaVA 用 3.6B 的稀疏激活参数在 SQAI 上超过了 LLaVA-1.5-7B 1.9%。值得注意的是,由于 MoE-LLaVA 的稀疏结构,只需要 2.6B 的激活参数量就能全面超过 IDEFICS-80B。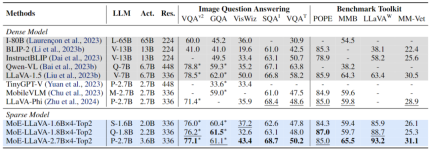
图 4 MoE-LLaVA 在 9 个 benchmark 上的性能另外,研究团队还关注到最近的小视觉语言模型 TinyGPT-V,MoE-LLaVA-1.8B×4 在相当的激活参数下在 GQA 和 VisWiz 分别超过 TinyGPT-V 27.5% 和 10%,这标志着 MoE-LLaVA 强大的理解能力在自然视觉中。为了更全面地验证 MoE-LLaVA 的多模态理解能力,该研究在 4 个 benchmark toolkit 上评估了模型性能。benchmark toolkit 是验证模型能否能自然语言问答的工具包,通常答案是开放性的并且无固定模板。如图 4 所示,MoE-LLaVA-1.8B×4 超过了 Qwen-VL,后者使用更大的图片分辨率。这些结果都展示了 MoE-LLaVA 这一稀疏模型可以用更少的激活参数达到和稠密模型相当甚至超过的性能。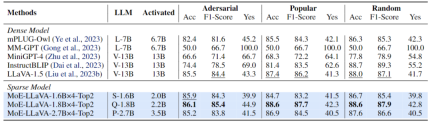
图 5 MoE-LLaVA 在幻觉物体检测上的性能评估该研究采用 POPE 评估 pipeline 来验证 MoE-LLaVA 的物体幻觉,结果如图 5 所示,MoE-LLaVA 展现出最好的性能,意味着 MoE-LLaVA 倾向于生成与给定图像一致的对象。具体的,MoE-LLaVA-1.8B×4 以 2.2B 的激活参数超过了 LLaVA。另外,研究团队观察到 MoE-LLaVA 的 yes ratio 占比处于较均衡状态,这表明稀疏模型 MoE-LLaVA 能够根据问题做出正确的反馈。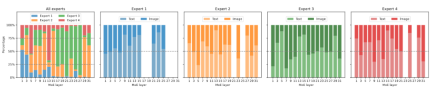
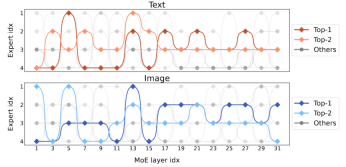
图 6 展示了在 ScienceQA 上 MoE-LLaVA-2.7B×4-Top2 的专家负载。整体上,在训练初始化时,所有的 MoE 层 中的专家的负载比较平衡。然而随着模型逐渐被稀疏化,第 17 到 27 层的专家的负载突然增大,甚至几乎包揽了所有 token。对于浅层的 5-11 层,主要是由专家 2、3、4 共同协作。值得关注的是,专家 1 几乎只在第 1-3 层工作,随着模型变深,专家 1 逐渐退出了工作。因此,MoE-LLaVA 的专家们学到了某种特定的模式,它能够按照一定的规律进行专家分工。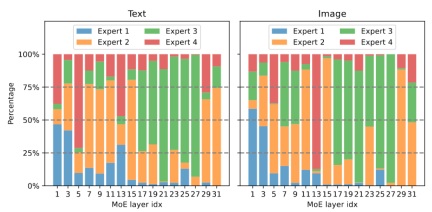
图 7 展示了不同专家的模态分布。该研究发现 text 和 image 的路由分布极其相似,例如当专家 3 在 17-27 层努力工作时,它所处理的 text 和 image 的占比是相似的。这表明 MoE-LLaVA 对于模态并无明显的偏好。该研究还在 token level 上观察了专家们的行为,并在下游任务上跟踪所有 token 在稀疏网络中的轨迹。对 text 和 image 所有激活的通路,该研究采用 PCA 降维得到主要的 10 条通路,如图 8 所示。研究团队发现对于某个未见的 text token 或 image token,MoE-LLaVA 始终偏向于派发专家 2 和 3 来处理模型深层。专家 1、4 倾向于处理初始化的 token。这些结果能够帮助我们更好地理解稀疏模型在多模态学习上的行为,并探索未知的可能。