






文档解析涉及检查文档中的数据并提取有用的信息。它可以通过自动化减少了大量的手工工作。一种流行的解析策略是将文档转换为图像并使用计算机视觉进行识别。而文档图像分析(document image analysis)是指从文档的图像的像素数据中获取信息的技术,在某些情况下,预期结果应该是什么样的没有明确的答案(文本、图像、图表、数字、表格、公式……)。
OCR (Optical Character Recognition,光学字符识别)是通过计算机视觉对图像中的文本进行检测和提取的过程。它是在第一次世界大战期间发明的,当时以色列科学家伊曼纽尔·戈德堡(Emanuel Goldberg)发明了一台能读取字符并将其转换为电报代码的机器。到了现在该领域已经达到了一个非常复杂的水平,混合图像处理、文本定位、字符分割和字符识别。基本上是一种针对文本的对象检测技术。
在本文中我将展示如何使用OCR进行文档解析。我将展示一些有用的Python代码,这些代码可以很容易地用于其他类似的情况(只需复制、粘贴、运行),并提供完整的源代码下载。
这里将以一家上市公司的PDF格式的财务报表为例(链接如下)。
https://s2.q4cdn.com/470004039/files/doc_financials/2021/q4/_10-K-2021-(As-Filed).pdf
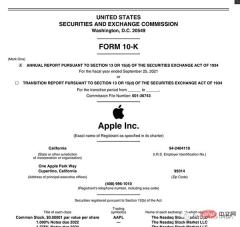
检测和提取该PDF中的 文本、图形和表格
环境设置
文档解析令人烦恼的部分是,有太多的工具用于不同类型的数据(文本、图形、表格),但没有一个能够完美地工作。下面是一些最流行方法和软件包:
- 以文本方式处理文档:用PyPDF2提取文本,用Camelot或TabulaPy提取表,用PyMuPDF提取图形。
- 将文档转换为图像(OCR):使用pdf2image进行转换,使用PyTesseract以及许多其他的库提取数据,或者只使用LayoutParser。
也许你会问:“为什么不直接处理PDF文件,而要把页面转换成图像呢?”你可以这么做。这种策略的主要缺点是编码问题:文档可以采用多种编码(即UTF-8、ASCII、Unicode),因此转换为文本可能会导致数据丢失。因此为了避免产生该问题,我将使用OCR,并用pdf2image将页面转换为图像,需要注意的是PDF渲染库Poppler是必需的。
# with pip
pip install python-poppler
# with conda
conda install -c conda-forge poppler
你可以很容易地读取文件:
# READ AS IMAGE
import pdf2imagedoc = pdf2image.convert_from_path("doc_apple.pdf")
len(doc) #<p>跟我们的截图一模一样,如果想将页面图像保存在本地,可以使用以下代码:</p><pre class="brush:python;toolbar:false;"># Save imgs
import osfolder = "doc"
if folder not in os.listdir():
 os.makedirs(folder)p = 1
for page in doc:
 image_name = "page_"+str(p)+".jpg"
 page.save(os.path.join(folder, image_name), "JPEG")
 p = p+1
最后,我们需要设置将要使用的CV引擎。LayoutParser似乎是第一个基于深度学习的OCR通用包。它使用了两个著名的模型来完成任务:
Detection: Facebook最先进的目标检测库(这里将使用第二个版本Detectron2)。
pip install layoutparser torchvision && pip install "git+https://github.com/facebookresearch/detectron2.git@v0.5#egg=detectron2"
Tesseract:最著名的OCR系统,由惠普公司在1985年创建,目前由谷歌开发。
pip install "layoutparser[ocr]"
现在已经准备好开始OCR程序进行信息检测和提取了。
import layoutparser as lp
import cv2
import numpy as np
import io
import pandas as pd
import matplotlib.pyplot as plt
检测
(目标)检测是在图片中找到信息片段,然后用矩形边框将其包围的过程。对于文档解析,这些信息是标题、文本、图形、表……

当现有的脚本或服务需要将作用域化的仓库工作委托给 Claude Code 并以编程方式消费结构化响应时,请使用 Claude Agent SDK for Python。
让我们来看一个复杂的页面,它包含了一些东西:
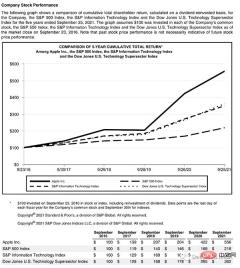
这个页面以一个标题开始,有一个文本块,然后是一个图和一个表,因此我们需要一个经过训练的模型来识别这些对象。幸运的是,Detectron能够完成这项任务,我们只需从这里选择一个模型,并在代码中指定它的路径。
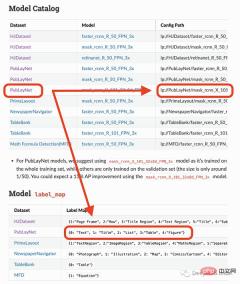
我将要使用的模型只能检测4个对象(文本、标题、列表、表格、图形)。因此,如果你需要识别其他东西(如方程),你就必须使用其他模型。
## load pre-trained model
model = lp.Detectron2LayoutModel(
 "lp://PubLayNet/mask_rcnn_X_101_32x8d_FPN_3x/config",
 extra_config=["MODEL.ROI_HEADS.SCORE_THRESH_TEST", 0.8],
 label_map={0:"Text", 1:"Title", 2:"List", 3:"Table", 4:"Figure"})
## turn img into array
i = 21
img = np.asarray(doc[i])
## predict
detected = model.detect(img)
## plot
lp.draw_box(img, detected, box_width=5, box_alpha=0.2,
 show_element_type=True)
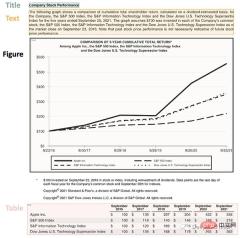
结果包含每个检测到的布局的细节,例如边界框的坐标。根据页面上显示的顺序对输出进行排序是很有用的:
## sort
new_detected = detected.sort(key=lambda x: x.coordinates[1])
## assign ids
detected = lp.Layout([block.set(id=idx) for idx,block in
 enumerate(new_detected)])## check
for block in detected:
 print("---", str(block.id)+":", block.type, "---")
 print(block, end='nn')
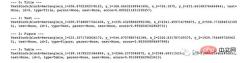
完成OCR的下一步是正确提取检测到内容中的有用信息。
提取
我们已经对图像完成了分割,然后就需要使用另外一个模型处理分段的图像,并将提取的输出保存到字典中。
由于有不同类型的输出(文本,标题,图形,表格),所以这里准备了一个函数用来显示结果。
'''
{'0-Title': '...',
'1-Text': '...',
'2-Figure': array([[ [0,0,0], ...]]),
'3-Table': pd.DataFrame,
}
'''
def parse_doc(dic):
 for k,v in dic.items():
 if "Title" in k:
 print('x1b[1;31m'+ v +'x1b[0m')
 elif "Figure" in k:
 plt.figure(figsize=(10,5))
 plt.imshow(v)
 plt.show()
 else:
 print(v)
 print(" ")
首先看看文字:
# load model
model = lp.TesseractAgent(languages='eng')
dic_predicted = {}
for block in [block for block in detected if block.type in ["Title","Text"]]:
 ## segmentation
 segmented = block.pad(left=15, right=15, top=5,
 bottom=5).crop_image(img)
 ## extraction
 extracted = model.detect(segmented)
 ## save
 dic_predicted[str(block.id)+"-"+block.type] =
 extracted.replace('n',' ').strip()
# check
parse_doc(dic_predicted)

再看看图形报表
for block in [block for block in detected if block.type == "Figure"]:
 ## segmentation
 segmented = block.pad(left=15, right=15, top=5,
 bottom=5).crop_image(img)
 ## save
 dic_predicted[str(block.id)+"-"+block.type] = segmented
# check
parse_doc(dic_predicted)
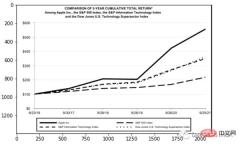
上面两个看着很不错,那是因为这两种类型相对简单,但是表格就要复杂得多。尤其是我们上看看到的的这个,因为它的行和列都是进行了合并后产生的。
for block in [block for block in detected if block.type == "Table"]:
 ## segmentation
 segmented = block.pad(left=15, right=15, top=5,
 bottom=5).crop_image(img)
 ## extraction
 extracted = model.detect(segmented)
 ## save
 dic_predicted[str(block.id)+"-"+block.type] = pd.read_csv(
 io.StringIO(extracted) )
# check
parse_doc(dic_predicted)
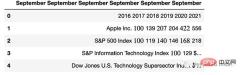
正如我们的预料提取的表格不是很好。好在Python有专门处理表格的包,我们可以直接处理而不将其转换为图像。这里使用TabulaPy 包:
import tabula
tables = tabula.read_pdf("doc_apple.pdf", pages=i+1)
tables[0]
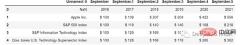
结果要好一些,但是名称仍然错了,但是效果要比直接OCR好的多。
总结
本文是一个简单教程,演示了如何使用OCR进行文档解析。使用Layoutpars软件包进行了整个检测和提取过程。并展示了如何处理PDF文档中的文本,数字和表格。
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!
















