






前言
.net运行库通过垃圾回收器自动处理回收托管资源,非托管的资源需要手动编码处理。理解内存管理的工作原理,有助于提高应用程序的速度和性能。废话少说,切入正题。
主要阐述的概念见下图:
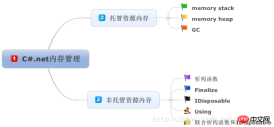
概念
内存:又称为虚拟内存,或虚拟地址空间,windows使用虚拟寻址系统,在后台自动将可用的内存地址映射到硬件内存中的实际地址上,其结果便是32位处理器上的每个进程都可以使用4gb的内存,用来存放程序的所有部分,包括可执行代码(exe文件),代码加载的所有dll,程序运行时使用的所有变量的内容。
内存栈
在进程的虚拟内存中,存在的一个变量的生存期必须嵌套的区域。
内存堆
在进程的虚拟内存中,在方法退出后的很长一段时间内数据仍是可用的区域。
托管资源
垃圾回收器在后台能自动处理的资源
非托管资源
需要手动编码,通过析构函数,finalize,idisposable,using等机制或方法处理的资源。
内存栈
值类型数据存储在内存栈中,引用类型的实例地址值也放在内存栈中(见内存堆的讨论),内存栈的工作原理,透过下面一段代码理解:
{ //block1开始
    int a;
    //solve something
    {//block2开始
       int b;
       // solve something else
    }//block2结束}//block1结束
以上代码注意2点:
1)C#中变量的作用域,遵循先声明的后超出作用域,后声明的先超出作用域,即b先释放,a后释放,释放顺序总是与它们分配内存的顺序相反。
2)b在一个单独的块作用域(block2)中,而a所在的块名称为block1,其内嵌套着block2。
请看下面示意图:
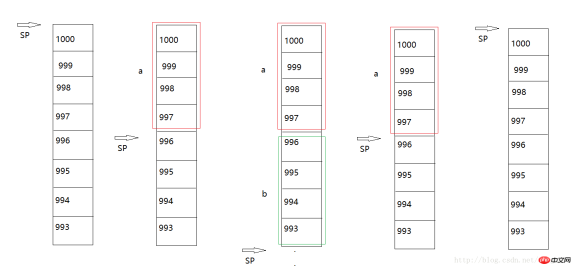
栈内存管理中,始终都维护着一个栈指针,它始终指向站区域中下一个可用的地址,名字为sp,如图所示,假定它指向编号为1000的地址。
变量a 首先入栈,假定机子是32位的,int型占4个字节,即997~1000,入栈后,sp指向996,可见内存栈的增长方向为从高地址向低地址方向。
然后b入栈,占据993~996,sp指向992。当超越块block2 时,变量b立即释放在内存栈上的存储,sp增加4个字节,指向996。
向外走,超越块block1 时,变量a 立即释放,此时sp再增加4个字节,指向原来的初始地址1000,后面再入栈时,这些地址再被占用,然后再被释放,循环往复。
内存堆
尽管栈有非常高的性能,但对于所有的变量它还是不太灵活,因为位于内存栈上的变量的生存期必须嵌套。许多情况下,这种要求过于苛刻,因为我们希望有些数据在方法退出后的很长一段时间内还是可用的。
只要是用new运算符来请求的堆存储空间,就满足数据声明期延时性,例如所有的引用类型。在.net中使用托管堆来管理内存堆上的数据。
.net中的托管堆和C++使用的堆不同,它在垃圾回收器的控制下工作,而C++的堆是低级的。
既然引用类型的数据存储在托管堆上,那么它们是如何存储的呢?请看下面代码
void Shout()
{
   Monkey xingxing; //猴子类
   xingxing = new Monkey();
}
在这段代码中,假定两个类Monkey和AIMonkey,其中AIMonkey类扩展了Monkey对象。
在这里,我们称Monkey为一个对象,称xingxing为它的一个实例。
首先,声明了一个Monkey引用xingxing,在栈上给这个引用分配存储空间,记住这仅是一个引用,而不是实际的Monkey对象。记住这一点很重要!!!
然后看下第2行代码:
xingxing = new Monkey();
它完成的操作:首先,它分配堆上的内存,以储存Monkey对象,注意了!!!这是一个真正的对象,它不是一个占用4个字节的地址!!! 假定Monkey对象占用64个字节,这64个字节包含了Monkey实例的字段,和.NET中用于识别和管理Monkey类实例的一些信息。这64个字节实在内存堆上分配的,假定内存堆上的地址1937~2000。new操作符返回一个内存地址,假定为997~1000,并赋值给xingxing。示意图如下所示:
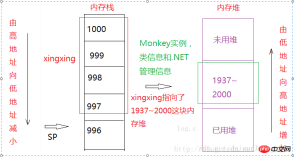
记住一点:
与内存栈不同的是,堆上的内存是向上分配的,由低地址到高地址。
从上面的例子中,可以看出建立引用实例的过程要比建立值变量的过程更复杂,系统开销更大。那么既然开销这么大,它到底优势何在呢?引用数据类型强大到底在哪里???
请看下面代码:
 {//block1
    Monkey xingxing; //猴子类
    xingxing = new Monkey();
    {//block2
      Monkey jingjing = xingxing; //jingjing也引用了Monkey对象
      //do something
    }    //jinjing超出作用域,它从栈中删除
    //现在只有xingxing还在引用Monkey}//xingxing超出作用域,它从栈中删除//现在没有在引用Monkey的了
把一个引用实例的值xingxing赋值予另一个相同类型的实例jingjing,这样的结果便是有两个引用内存中的同一个对象Monkey了。当一个实例超出作用域时,它会从栈中删除,但引用对象的数据还是保留在堆中,一直到程序终止,或垃圾回收器回收它位置,而只有该数据不再有任何实例引用它时,它才会被删除!
随便举一个实际应用引用的简单例子:
//从界面抓取数据放到list中List<person> persons = getPersonsFromUI();
//retrieve these persons from DBList<person> personsFromDB = retrievePersonsFromDB();
//do something to personsFromDBgetSomethingToPersonsFromDB();</person></person>
请问对personsFromDB的改变,能在界面上及时相应出来吗?
不能!
请看下面修改代码:
//从界面抓取数据放到list中List<person> persons = getPersonsFromUI();
//retrieve these persons from DBList<person> personsFromDB = retrievePersonsFromDB();
int cnt = persons.Count;for(int i=0;i<cnt><p> 修改后,数据能立即响应在界面上。因为persons与UI绑定,所有修改在persons上,自然可以立即响应。 <br>  这就是引用数据类型的强大之处,在C#.NET中广泛使用了这个特性。这表明,我们可以对数据的生存期进行非常强大的控制,因为只要保持对数据的引用,该数据就肯定位于堆上!!! <br>  这也表明了基于栈的实例与基于堆的对象的生存期不匹配!</p>
<h2><span style="color:blue">垃圾回收器 GC</span></h2>
<p>   内存堆上会有碎片形成,.NET垃圾回收器会压缩内存堆,移动对象和修改对象的所有引用的地址,这是托管的堆与非托管的堆的区别之一。 <br>   .NET的托管堆只需要读取堆指针的值即可,但是非托管的旧堆需要遍历地址链表,找出一个地方来放置新数据,所以在.NET下实例化对象要快得多。 <br>
   堆的第一部分称为第0代,这部分驻留了最新的对象。在第0代垃圾回收过程中遗留下来的旧对象放在第1代对应的部分上,依次<a href="http://www.php.cn/wiki/80.html" target="_blank">递归</a>下去。。。</p>
<h2>承上启下</h2>
<p>  以上部分便是对托管资源的内存管理部分,这些都是在后台由.NET自动执行的。下面看下非托管资源的内存管理,比如这些资源可能是UI句柄,network连接,文件句柄,Image对象等。.NET主要通过三种机制来做这件事。分别为析构函数、IDisposable<a href="http://www.php.cn/code/11829.html" target="_blank">接口</a>,和两者的结合处理方法,以此实现最好的处理结果。下面分别看一下。</p>
<h2><span style="color:blue">析构函数</span></h2>
<p>  C#编译器在编译析构函数时,它会隐式地把析构函数的代码编译为等价于Finalize()方法的代码,并确定执行父类的Finalize()方法。看下面的代码:</p>
<pre class="brush:c#;toolbar:false;">public class Person
{
   ~Person()
   {      //析构实现
   }
}
~Person()析构函数生成的IL的C#代码:

protected override void Finalize()
{   try
   {      //析构实现
   }   finally
   {     base.Finalize();
   }
}
放在finally块中确保父类的Finalize()一定调用。
C#析构函数要比C++析构函数的使用少很多,因为它的问题是不确定性。在销毁C++对象时,其析构函数会立即执行。但由于C#使用垃圾回收器,无法确定C#对象的析构函数何时执行。如果对象占用了 宝贵的资源,而需要尽快释放资源,此时就不能等待垃圾回收器来释放了。
第一次调用析构函数时,有析构函数的对象需要第二次调用析构函数,才会真正删除对象。如果频繁使用析构,对性能的影响非常大。
IDisposable接口
在C#中,推荐使用IDisposable接口替代析构函数,该模式为释放非托管资源提供了确定的机制,而不像析构那样何时执行不确定。
假定Person对象依赖于某些外部资源,且实现IDisposable接口,如果要释放它,可以这样:
class Person:IDisposable
{  public void Dispose()
  {    //implementation
  }
}

Person xingxing = new Person();//dom somethingxingxing .Dispose();
上面代码如果在处理过程中出现异常,这段代码就没有释放xingxing,所以修改为:
Person xingxing = null;try{
   xingxing  = new Person();   //do something}finally{   if(xingxing !=null)
    {
        xingxing.Dispose();
    }
}
C#提供了一种语法糖,叫做using,来简化以上操作。
using(Person xingxing = new Person())
{  // do something}
using在此处的语义不同于普通的引用类库作用。using用在此处的功能,仅仅是简化了代码,这种语法糖可以少用!!!
总之,实现IDisposable的对象,在释放非托管资源时,必须手动调用Dispose()方法。因此一旦忘记,就会造成资源泄漏。如下所示:
                Image backImage = this.BackgroundImage;
                if (backImage != null)
                {
                    backImage.Dispose();
                    SessionToImage.DeleteImage(_imageFilePath, _imageFileName);
                    this.BackgroundImage = null;
                }
在上面那个例子中,backImage已经确定不再用了,并且backImage又是通过Image.FromFile(fullPathWay)从物理磁盘上读取的,是非托管的资源,所以需要Dispose()一下,这样读取Image的这个进程就被关闭了。如果忘记写backImage.Dispose();就会造成资源泄漏!
结合 析构函数和IDisposable这2种机制
一般情况下,最好的方法是实现两种机制,获得这两种机制的优点。因为正确调用Dispose()方法,同时把实现析构函数作为一种安全机制,以防没有调用Dispose()方法。请参考一种结合两种方法释放托管和非托管资源的机制:
public class Person:IDisposable
{   private bool isDisposed = false;
//实现IDisposable接口
   public void Dispose()
   {
   //为true表示清理托管和非托管资源
      Dispose(true);
      //告诉垃圾回收器不要调用析构函数了
      GC.SuppressFinalize(this);
   }
   protected virtual void Dispose(bool disposing)
   {
   //isDisposed: 是否对象已经被清理掉了
      if(!isDisposed)
      {
      if(disposing)
          {
          //清理托管资源
           }
           //清理非托管资源
       }
       isDisposed = true;
   }

   ~Person()
   {
   //false:调用后只清理非托管资源
     //托管资源会被垃圾回收器的一个单独线程Finalize()
     Dispose(false);
   }
}
当这个对象的使用者,直接调用了Dispose()方法,比如
Person xingxing = new Person();//do somethingperson.Dispose();
此时调用IDisposable.Dispose()方法,指定应清理所有与该对象相关的资源,包括托管和非托管资源。
如果未调用Dispose()方法,则是由析构函数处理掉托管和非托管资源。











