






go-zero框架中批量操作的核心优化手段是避免在循环中逐条执行sql,改为使用支持批量语法的orm方法或手动拼接insert语句。具体做法是将数据切片一次性传入`insertmany`等接口,或者利用数据库驱动层面的批量特性,从而显著减少网络往返和事务开销。
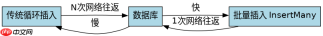
InsertMany如何替代循环插入
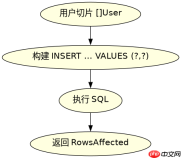
使用InsertMany可以将多个对象合并为一条SQL语句执行。相比在for循环里调用Insert,这种方法能大幅降低数据库连接的压力。输入是一个包含多个结构体的切片,输出是受影响的行数。如果数据量极大,建议分片处理以防内存溢出。
package main

import (
	"context"
	"fmt"
	"log"

	"github.com/zeromicro/go-zero/core/stores/sqlx"
)

type User struct {
	Id   int64  `db:"id"`
	Name string `db:"name"`
}

func main() {
	// 假设已初始化 sqlConn
	var sqlConn sqlx.SqlConn = nil
	ctx := context.Background()
	users := []User{
		{Name: "Alice"},
		{Name: "Bob"},
		{Name: "Charlie"},
	}
	// 批量插入
	result, err := sqlConn.InsertMany(ctx, "INSERT INTO users (name) VALUES (?)", users)
	if err != nil {
		log.Fatal(err)
	}
	affected, _ := result.RowsAffected()
	fmt.Println("Inserted rows:", affected)
}
批量更新如何处理冲突与性能
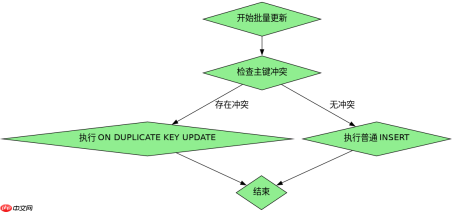
批量更新通常涉及ON DUPLICATE KEY UPDATE语法。在Go-Zero中,可以通过自定义SQL或使用Exec配合拼接字符串来实现。输入是待更新的数据列表,输出是更新后的状态。需要注意参数绑定的顺序,确保与VALUES子句对应。对于高并发场景,应控制单次批量大小以维持事务稳定性。

Drizzle ORM TypeScript SQL 数据库工具包
下载
Drizzle ORM 是一个轻量级的 TypeScript ORM,提供类型安全的 SQL 模式声明、关系型和类 SQL 查询构建器,以及自动生成迁移。其压缩后仅 7.4kb,且无依赖项,支持 PostgreSQL、MySQL 和 SQLite,包括 Neon、Turso 和 Cloudflare D1 等无服务器数据库。
package main

import (
	"context"
	"fmt"
	"log"

	"github.com/zeromicro/go-zero/core/stores/sqlx"
)

type Product struct {
	Id    int64  `db:"id"`
	Price float64 `db:"price"`
}

func main() {
	var sqlConn sqlx.SqlConn = nil
	ctx := context.Background()
	products := []Product{
		{Id: 1, Price: 10.5},
		{Id: 2, Price: 20.0},
	}
	// 构建批量更新SQL
	// 注意:实际生产中建议使用sqlc或genny生成代码,此处演示原生写法
	query := "INSERT INTO products (id, price) VALUES (?, ?) ON DUPLICATE KEY UPDATE price = VALUES(price)"
	// 由于go-zero原生不支持直接传slice给带多参数的update,通常需循环或拼接
	// 这里展示一种简化的逻辑,实际需根据驱动支持情况调整
	for _, p := range products {
		_, err := sqlConn.ExecCtx(ctx, query, p.Id, p.Price)
		if err != nil {
			log.Fatal(err)
		}
	}
	fmt.Println("Batch update completed")
}
大批量数据导入时的内存限制问题
当一次性传入数万条数据时,InsertMany可能导致内存峰值过高。此时应将大切片拆分为固定大小的子切片(如每批1000条),循环执行批量插入。这种分片策略能保持内存平稳,同时享受批量操作的IO优势。输入是分片后的数据块,输出是累计的受影响行数。通过这种方式,可以在不增加服务器负担的前提下完成海量数据入库。














