






使用elk聚合java gc日志的核心做法是配置logstash的grok过滤器解析非结构化文本,将gc时间、堆内存变化等关键指标提取为结构化字段,随后存入elasticsearch进行可视化分析。具体操作是在logstash配置中定义匹配gc日志模式的正则表达式,并设置输出目标为es集群,这样就能通过kibana仪表盘直观监控jvm垃圾回收行为。

如何编写Grok模式解析标准GC日志
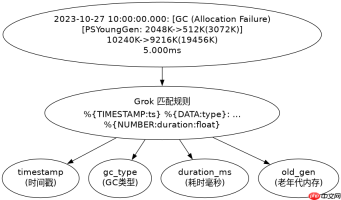
直接回答:需要针对HotSpot JVM输出的特定GC日志格式编写自定义Grok正则表达式,以捕获时间戳、GC类型、耗时及内存变化数据。主要依赖%{TIMESTAMP_ISO8601}和自定义命名组来提取关键字段,确保能准确区分Young GC和Full GC事件。
input {
  file {
    path => "/var/log/java/gc.log"
    start_position => "beginning"
    sincedb_path => "/dev/null"
  }
}

filter {
  grok {
    match => { "message" => "%{TIMESTAMP_ISO8601:timestamp} %{DATA:gc_type}: \[%{DATA:old_gen}\] (%{NUMBER:duration_ms:float})" }
  }
  date {
    match => [ "timestamp", "yyyy-MM-dd HH:mm:ss,SSS" ]
    target => "@timestamp"
  }
}

output {
  elasticsearch {
    hosts => ["localhost:9200"]
    index => "java-gc-logs-%{+YYYY.MM.dd}"
  }
}
上述配置展示了从文件输入到Grok解析再到ES输出的完整流程。其中match字段定义了核心解析逻辑,duration_ms被显式转换为浮点数以便后续计算。运行该配置后,日志将被结构化存储,可通过查询gc_type字段筛选特定类型的GC事件。
如何在Kibana中构建GC性能监控仪表盘
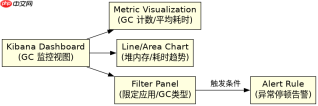
直接回答:在Kibana中创建Dashboard,利用Metric Visualizations展示GC频率和平均耗时,使用Line或Area图表绘制堆内存随时间的变化趋势。通过添加Filter面板限定特定应用或GC类型,实现实时性能监控。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
// 假设已通过Logstash导入数据,此处为Kibana Dev Tools中的查询示例
GET java-gc-logs-*/_search
{
  "size": 0,
  "aggs": {
    "gc_count_by_type": {
      "terms": {
        "field": "gc_type.keyword"
      }
    },
    "avg_gc_duration": {
      "avg": {
        "field": "duration_ms"
      }
    }
  }
}
这段代码演示了如何通过聚合查询快速获取GC统计信息。在实际操作中,建议在Kibana界面中基于这些聚合结果创建可视化组件。例如,创建一个折线图,X轴为@timestamp,Y轴为duration_ms的平均值,可以清晰看到GC耗时 spikes。同时,结合old_gen字段的数值变化,可以判断是否发生了内存泄漏或堆配置不当。
当GC日志出现异常停顿时应如何定位根因
直接回答:通过分析Kibana中筛选出的高耗时GC记录,检查对应的old_gen内存占用率及gc_type是否为Full GC。若发现频繁Full GC且伴随老年代内存激增,通常指向内存泄漏或堆大小设置不合理,需结合JVM参数如-XX:+PrintGCDetails进一步导出详细日志进行离线分析。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


