






在java中使用completablefuture提升性能的核心做法是结合本地缓存(如caffeine)与异步计算,利用`supplyasync`将耗时任务提交到线程池执行,并在获取结果前检查缓存。具体实现时,先通过`getifpresent`查询缓存,若命中则直接返回已完成的future;若未命中,则使用`computeasync`或手动封装`completablefuture.supplyasync`来执行计算并回填缓存,从而避免重复计算和阻塞等待。

如何构建带缓存的异步数据加载器
构建带缓存的异步数据加载器需要定义一个包含缓存实例和线程池的服务类。核心逻辑是在请求数据时,先尝试从缓存中获取,如果存在则立即返回对应的CompletableFuture,否则触发异步计算并将结果存入缓存。这种模式确保了并发请求同一数据时,只有第一个请求会执行实际计算,后续请求直接复用结果。
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import com.github.benmanes.caffeine.cache.Cache;
import com.github.benmanes.caffeine.cache.Caffeine;

public class AsyncCacheLoader {
    private final Cache<string string> cache = Caffeine.newBuilder()
            .maximumSize(1000)
            .build();
    private final ExecutorService executor = Executors.newFixedThreadPool(4);

    public CompletableFuture<string> getData(String key) {
        String cachedValue = cache.getIfPresent(key);
        if (cachedValue != null) {
            return CompletableFuture.completedFuture(cachedValue);
        }
        return CompletableFuture.supplyAsync(() -> {
            String value = fetchFromSource(key); // 模拟耗时操作
            cache.put(key, value);
            return value;
        }, executor);
    }

    private String fetchFromSource(String key) {
        try { Thread.sleep(1000); } catch (InterruptedException e) {}
        return "Data-" + key;
    }
}</string></string>
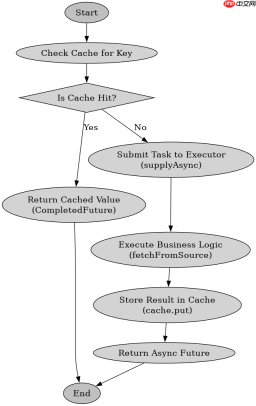
上述代码定义了一个简单的异步缓存加载器。当调用getData方法时,首先检查cache中是否存在键为key的值。如果存在,直接返回一个已完成且包含该值的CompletableFuture。如果不存在,则使用CompletableFuture.supplyAsync将fetchFromSource方法的执行提交到线程池。计算完成后,结果被放入缓存并作为Future的结果返回。这种方式有效减少了重复的I/O或计算开销。
如何处理缓存缺失时的并发竞争问题
处理缓存缺失时的并发竞争问题通常采用“计算并放置”(compute and put)策略,或者使用更高级的缓存库提供的异步计算功能。在基础实现中,如果不加锁,多个线程可能同时发现缓存缺失并发起重复计算。虽然这不会导致数据错误,但会浪费资源。更优的做法是利用Cache.asMap().computeIfAbsent配合CompletableFuture,确保对于同一个键,只有一个异步任务被创建和执行,其他线程等待该任务完成。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。

import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import com.github.benmanes.caffeine.cache.Cache;
import com.github.benmanes.caffeine.cache.Caffeine;

public class OptimizedAsyncCacheLoader {
    private final Cache<string completablefuture>> cache = Caffeine.newBuilder()
            .maximumSize(1000)
            .build();
    private final ExecutorService executor = Executors.newFixedThreadPool(4);

    public CompletableFuture<string> getData(String key) {
        return cache.get(key, k -> {
            return CompletableFuture.supplyAsync(() -> {
                String value = fetchFromSource(k);
                return value;
            }, executor);
        }).thenApply(future -> {
            try {
                return future.get();
            } catch (Exception e) {
                throw new RuntimeException(e);
            }
        });
    }

    private String fetchFromSource(String key) {
        try { Thread.sleep(1000); } catch (InterruptedException e) {}
        return "Optimized-Data-" + key;
    }
}</string></string>
这段代码展示了如何处理并发竞争。这里缓存存储的是CompletableFuture对象。使用cache.get(key, k -> ...)方法,Caffeine保证对于给定的key,只有当缓存中不存在时才执行lambda表达式。这意味着即使多个线程同时请求同一个不存在的key,也只会创建一个CompletableFuture实例。其他线程将获得同一个Future实例,并通过thenApply或get等待其完成。这种方式既利用了异步非阻塞的优势,又避免了重复计算,提升了整体吞吐量。
当缓存键冲突时程序的具体行为是什么
当缓存键冲突时,即多个不同的业务逻辑试图写入相同的缓存键,程序的行为取决于具体的实现细节。在上述基于Caffeine的实现中,如果两个不同的异步任务最终计算出不同的值并尝试放入同一个键,后写入的值会覆盖先写入的值。由于我们使用的是cache.get(key, mappingFunction),它保证了对于特定键只有一个映射函数被执行,因此不会出现真正的“冲突”覆盖问题,而是串行化了对该键的计算初始化过程。如果手动使用put方法且没有同步机制,则最后执行的put操作的结果将成为缓存中的最终值,之前的计算结果将被丢弃。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



