针对千万级数据,xorm深分页优化的核心方案是放弃基于偏移量(offset)的传统分页,改用基于游标(cursor)或范围查询的分页方式。具体做法是利用主键或唯一索引字段,记录上一页最后一条数据的id值,在下一页查询时通过 `where id > last_id` 条件限制扫描范围,从而避免 offset 带来的全表扫描和排序开销。

为什么传统 OFFSET 分页在大数据量下性能极差
当使用传统的 OFFSET N LIMIT M 语法时,数据库必须扫描前 N+M 条记录,然后丢弃前 N 条,仅返回后 M 条。随着 N 的增大,这种“跳过”操作会导致大量的 I/O 和 CPU 资源浪费,且无法利用索引加速,因为索引通常只用于定位起始点,而 OFFSET 需要回表或全索引扫描来计数。
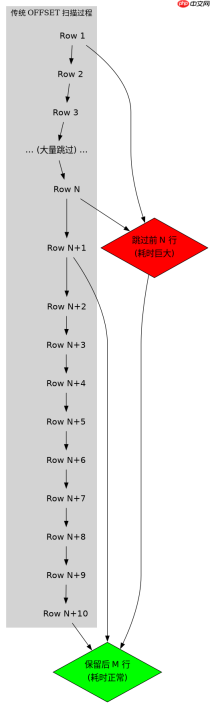
-- 传统分页:N=1000000, M=10
-- XORM 等价写法
orm.Where("id > 0").Limit(10).Offset(1000000).Find(&users)

-- 实际执行逻辑:
-- 1. 扫描索引树找到第 1,000,000 条记录
-- 2. 继续扫描接下来的 10 条记录
-- 3. 将前 1,000,000 条记录从内存缓冲区中丢弃
-- 4. 返回剩余的 10 条
-- 问题:扫描行数 = 1,000,010,时间复杂度 O(N)
在 XORM 中,直接调用 Limit() 和 Offset() 会生成标准的 SQL。对于千万级数据,即使有主键索引,数据库引擎仍需遍历大量行以计算偏移量。如果数据没有连续的主键(如存在删除),这种开销会更加严重,因为数据库需要填充空缺位置直到达到指定的偏移量。
如何基于游标实现高效的范围查询
优化后的方案是利用上一页最后一条记录的 ID 作为“游标”,在下一页查询时指定 WHERE id > cursor_id。这样,数据库可以直接利用主键索引定位到 cursor_id 之后的第一条记录,并快速读取后续的 M 条数据。无论当前页码多大,扫描的行数始终接近于 M,时间复杂度稳定为 O(log N + M)。

// 假设第一页查询结果中最后一条记录的 ID 为 1000000
// 获取下一页数据
var users []User
lastId := int64(1000000) // 来自上一页最后一条数据

// XORM 游标分页写法
err := orm.Where("id > ?", lastId).Order("id ASC").Limit(10).Find(&users)

// 实际执行逻辑:
// 1. 利用主键索引快速定位 ID > 1000000 的第一个节点
// 2. 顺序读取接下来的 10 条记录
// 3. 返回这 10 条数据
// 优势:扫描行数 ≈ 10,时间复杂度 O(log N + M),与 N 无关
在实际开发中,需要确保每次查询都带上上一页的最后一条 ID。如果用户点击“下一页”,后端代码应从请求参数中解析出 last_id,并将其传入 Where 条件。若 last_id 为空,则视为第一页,不使用 WHERE 条件。这种方式不仅适用于整数主键,也适用于时间戳等有序字段,但需保证字段的单调递增性以避免数据重复或遗漏。
当数据存在并发插入导致游标跳跃时如何处理
在使用基于 ID 的游标分页时,如果数据库中存在高并发的插入操作,可能会导致“游标跳跃”现象。例如,用户在查看第 N 页时,新数据插入了比当前游标 ID 更大的位置,导致这些新数据在第 N+1 页被提前展示,或者在某些情况下,由于事务隔离级别不同,用户可能看到重复或缺失的数据。为确保一致性,建议在强一致性场景下使用快照隔离或结合版本号进行校验。
此外,如果业务允许一定的延迟一致性,可以接受轻微的游标跳跃。但在严格的数据导出或审计场景中,建议采用基于时间戳加 ID 的组合游标策略。即同时记录 created_at 和 id,查询条件变为 WHERE (created_at, id) > (last_created_at, last_id)。这样可以确保即使在高并发插入下,也能按严格的物理写入顺序遍历数据,避免漏读或重读。
另一种极端情况是数据删除导致的 ID 空洞。虽然游标分页不受空洞影响(因为它不依赖计数),但如果业务要求“逻辑上的第 N 条记录”,则游标分页不适用。此时应考虑使用 Elasticsearch 等搜索引擎进行分页,或在 MySQL 层面使用覆盖索引减少回表开销,但这仍无法解决 OFFSET 的根本性能瓶颈。因此,对于千万级以上的实时数据查询,游标分页仍是最佳实践。