






在sql中通过join关联两张千万级单表而不拖垮集群,核心策略是确保连接列具备高基数且存在索引,并在应用层或查询层实施数据过滤与分页。具体做法是在两表的关联键上建立b+树索引以加速查找,同时在where子句中引入时间范围、状态等过滤条件以减少参与join的数据量。若内存不足以支撑全量排序或哈希聚合,应启用磁盘临时表并合理配置`sort_buffer_size`和`join_buffer_size`。此外,避免使用select *,仅选取必要字段以降低网络传输和内存开销。
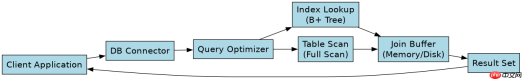
如何为千万级大表建立高效的JOIN索引结构
为了解决JOIN性能问题,必须在关联列上建立合适的索引。对于InnoDB引擎,主键索引和数据存储在聚簇索引中紧密相连,而二级索引则存储主键ID。当进行等值JOIN时,优化器倾向于使用覆盖索引或回表查询。如果关联列选择性低(如性别),索引可能失效;若选择性高(如用户ID),索引效率极高。建议检查执行计划中的type是否为ref或eq_ref,并确保using index被命中。
CREATE INDEX idx_user_id ON orders(user_id);
CREATE INDEX idx_user_id ON users(id); -- 假设users.id是主键

-- 验证执行计划
EXPLAIN SELECT o.order_id, u.username
FROM orders o
JOIN users u ON o.user_id = u.id
WHERE o.create_time > '2023-01-01';
上述代码展示了在orders表和users表的关联键上创建索引的过程。运行EXPLAIN后,若看到key列为idx_user_id,且rows预估扫描行数显著减少,说明索引生效。预期结果是Join操作从全表扫描变为索引查找,复杂度从O(N*M)降低至接近O(N log M)。
如何通过分区裁剪和过滤条件减少JOIN数据量
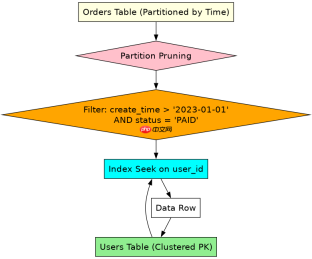
即使有索引,千万级数据的全量JOIN仍可能耗尽内存。此时需利用分区裁剪(Partition Pruning)或应用层过滤。如果表按时间分区,WHERE条件中包含分区键可大幅减少扫描范围。若无分区,应在JOIN前对驱动表进行预过滤。例如,只关联最近一个月的订单,可将数据量从千万降至百万甚至十万级。同时,使用LIMIT分页查询,避免一次性加载所有结果导致OOM。
-- 假设orders表按create_time按月分区
SELECT o.order_id, u.username
FROM orders o
PARTITION (p202310, p202311) -- 显式指定分区
JOIN users u ON o.user_id = u.id
WHERE o.status = 'PAID'
LIMIT 1000 OFFSET 0;
该代码演示了通过显式指定分区和添加状态过滤来缩小JOIN范围。预期输出仅为符合条件的少量记录,而非全表数据。注意,分区键必须是WHERE条件的一部分才能触发裁剪。若未命中分区,优化器会扫描所有分区,性能无提升。
当JOIN结果集超过内存限制时如何处理
当JOIN产生的中间结果集过大,超出`tmp_table_size`和`max_heap_table_size`限制时,MySQL会将内存临时表转换为磁盘临时表(MyISAM或InnoDB)。这会导致大量I/O操作,拖慢查询。解决方法是增加这两个参数的值,或者优化SQL避免不必要的排序和分组。若必须处理超大结果集,建议在应用层分批处理,或使用流式读取(Streaming)逐行处理结果,避免一次性将所有数据加载到内存中。


