






在sql server 2019中优化关联子查询,最直接且有效的做法是将其改写为join操作或使用窗口函数(如row_number),这能避免每行重复执行子查询带来的性能损耗。具体而言,若目标是去重或获取最新记录,使用带有partition by的row_number()配合cte通常比exists或in子查询更高效。此外,确保相关列上有合适的索引也是提升此类查询速度的关键前提。
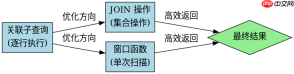
关联子查询与JOIN的性能差异
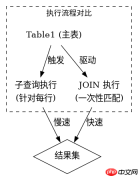
将关联子查询改写为JOIN可以显著减少执行计划中的嵌套循环次数,从而降低I/O开销。例如,当需要从主表中获取关联表的最新一条记录时,使用LEFT JOIN配合聚合函数或直接连接通常比WHERE EXISTS子句更快,因为JOIN允许优化器选择哈希匹配或合并连接等更高效的算法。
SELECT
    t1.ID,
    t1.Name,
    t2.LatestValue
FROM
    Table1 t1
LEFT JOIN (
    SELECT
        ID,
        Value AS LatestValue,
        ROW_NUMBER() OVER (PARTITION BY ID ORDER BY Date DESC) as rn
    FROM
        Table2
) t2 ON t1.ID = t2.ID AND t2.rn = 1;
上述代码展示了如何将原本可能需要子查询的逻辑转化为JOIN。预期结果是Table1的每一行都能快速匹配到Table2中对应ID的最新Value,且执行时间随数据量增长呈线性而非指数级增加。
利用窗口函数替代复杂子查询
对于需要按组排序并取极值的场景,SQL Server 2019的窗口函数提供了比传统子查询更清晰的语法和更好的优化空间。通过ROW_NUMBER()或RANK(),可以在单次扫描中完成分组排序,避免了子查询中的重复扫描表操作。

WITH RankedData AS (
    SELECT
        Category,
        ProductName,
        Price,
        ROW_NUMBER() OVER (PARTITION BY Category ORDER BY Price DESC) as Rank
    FROM
        Products
)
SELECT
    Category,
    ProductName,
    Price
FROM
    RankedData
WHERE
    Rank = 1;
该查询旨在找出每个类别中最贵的产品。预期输出是每个Category一行,包含最贵产品的名称和价格。相比使用MAX(Price)再JOIN回原表,这种方法逻辑更简洁,且在大数据集下执行计划通常更优。
索引对关联子查询执行计划的影响
即使改写了查询结构,如果缺乏适当的索引,SQL Server 2019仍可能被迫进行全表扫描。特别是在关联子查询中,被引用的列必须建立索引,以便数据库能快速定位匹配行。例如,在上述JOIN示例中,Table2的ID列和Date列应建立复合索引,以支持PARTITION BY和ORDER BY操作。


