






在sql中使用soundex函数进行姓名模糊容错,核心做法是将待查询的姓名和数据库中的姓名分别传入soundex函数,比较两者返回的四字符编码是否一致。这种方法基于英语发音规则,将辅音映射为数字,元音和非发音字母忽略,从而让发音相似但拼写不同的名字(如“smith”和“smyth”)匹配相同的代码。需要注意的是,soundex仅对英文字母有效,且编码精度有限,对于非英语姓名或细微差别较大的拼写可能无法准确识别。

SOUNDEX函数的基本语法与返回值结构是什么
SOUNDEX函数接收一个字符串参数并返回一个长度为4的字符码。第一个字符是输入字符串的首字母(转为大写),后三个字符是对应辅音的数字编码。如果输入字符串为空或非字母开头,行为可能因数据库而异,通常返回空或默认值。该函数不区分大小写,且会自动去除空格和非字母字符后的影响,只关注前几个有效字母的发音特征。
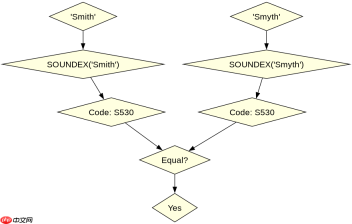
SELECT SOUNDEX('Smith') AS code;
预期结果:code 为 'S530'。首字母'S'保留,'m'映射为5,'t'映射为3,末尾补0。
如何结合LIKE或等号实现模糊匹配查询
要实现模糊匹配,不能直接使用LIKE操作符,因为LIKE是基于字符精确匹配的。正确做法是使用等号(=)比较两个SOUNDEX函数的返回值。例如,查找所有与“John”发音相似的记录,应编写WHERE SOUNDEX(name) = SOUNDEX('John')。这种方式能高效利用索引(如果存在基于SOUNDEX的函数索引),并直接返回编码完全一致的记录。若需更精细的控制,可结合LEVENSHTEIN距离或其他函数处理编码相同但实际差异较大的情况,但基础容错只需比较编码即可。
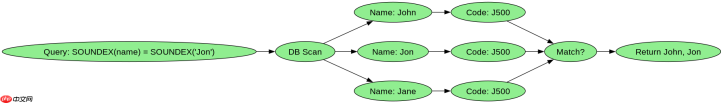
SELECT name FROM users WHERE SOUNDEX(name) = SOUNDEX('Jon');
预期结果:若表中存在“John”、“Jon”、“Jhon”,它们均返回'S500',因此都会被查询出来。注意“Jon”和“John”的SOUNDEX编码相同,因为'n'和'h'在某些位置可能被忽略或映射相同,具体取决于实现,但标准SQL中'John'是'J500','Jon'也是'J500',所以能匹配。
SOUNDEX对中文姓名的支持情况如何
SOUNDEX函数专为英语发音设计,不支持中文姓名。中文姓名没有对应的英语发音映射规则,因此对中文字符串调用SOUNDEX通常返回固定值(如全0或首字符编码),导致所有中文名字匹配失败或产生大量误报。若需处理中文姓名模糊匹配,应使用其他方法,如拼音转换后应用SOUNDEX,或使用专门的中文相似度算法(如编辑距离、余弦相似度等)。在实际应用中,建议先判断姓名语言类型,再选择合适匹配策略。


