






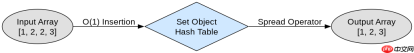
在 javascript 中,使用 set 对象配合展开运算符是处理常规数组去重性能最快且代码最简洁的方案。该方案利用底层哈希表实现 o(n) 的时间复杂度,避免了传统循环或 indexof 带来的重复遍历开销。对于包含基本数据类型的数组,直接返回 [...new set(arr)] 即可获得去重后的新数组。
为什么 Set 比 indexOf 快
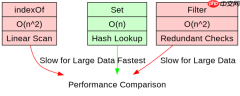
Set 的去重速度显著优于 indexOf 或 filter 方案,核心原因在于查找机制的差异。indexOf 每次都需要线性扫描已存在的元素,导致整体时间复杂度为 O(n²),而 Set 内部基于哈希表,插入和查找的平均时间复杂度均为 O(1)。这种底层实现的优化使得在处理大规模数据时,Set 的性能优势呈指数级放大。
const arr = [1, 2, 2, 3, 4, 4, 5];
const uniqueArr = [...new Set(arr)];
console.log(uniqueArr); // [1, 2, 3, 4, 5]
Map 与 Set 的对比场景
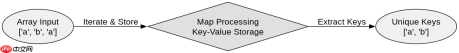
当需要保留原始数据的索引信息或进行更复杂的键值映射时,Map 是比 Set 更合适的选择。Map 同样具备 O(1) 的查找性能,但它允许存储键值对。通过以数组元素为键、索引为值,可以在去重的同时记录每个唯一元素首次出现的位置。这种模式适用于需要追踪数据来源或进行二次处理的业务逻辑。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
const arr = ['a', 'b', 'a', 'c'];
const map = new Map();
arr.forEach((item, index) => {
  if (!map.has(item)) {
    map.set(item, index);
  }
});
console.log([...map.keys()]); // ['a', 'b', 'c']
NaN 在去重中的特殊表现
在使用 Set 进行去重时,NaN 会被视为唯一的值,即使数组中存在多个 NaN,它们也会被合并为一个。这是因为 Set 内部使用类似 SameValueZero 的算法进行比较,其中 NaN === NaN 为 false,但 Set 将 NaN 视为相等的键。这一行为与传统的 === 比较不同,开发者需注意在涉及 NaN 的业务场景中验证结果是否符合预期。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南






