






处理 javascript web worker 通信超时的核心做法是引入定时器机制,在发起消息请求时启动计时器,若在规定时间内未收到响应则主动终止 worker 或抛出错误。具体实现中,通常结合 settimeout 与 postmessage 使用,通过设置合理的超时阈值来避免主线程因等待无响应的 worker 而长时间阻塞。这种做法能有效提升应用的健壮性,防止因 worker 内部死循环或逻辑错误导致的界面卡顿。
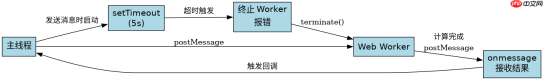
如何为单次 Worker 任务设置超时保护
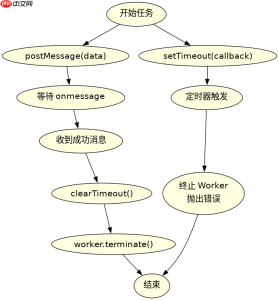
为单次任务设置超时保护的关键在于将 postMessage 调用与 setTimeout 绑定,并在回调中清理资源。开发者需要在主线程发送消息的同时创建一个定时器,一旦定时器触发,就执行清理逻辑,例如终止 Worker 实例并拒绝相关的 Promise(如果使用封装库)。这样做的结果是,即使 Worker 挂起,主线程也能在预定时间内恢复控制权,而不是无限期等待。需要注意的是,如果 Worker 在超时前完成了计算,必须清除该定时器以防止误报超时。
// main.js
const worker = new Worker('worker.js');
const timeoutMs = 5000;

// 创建超时定时器
const timerId = setTimeout(() => {
    console.error('Worker timed out');
    worker.terminate(); // 强制终止
}, timeoutMs);

// 监听 Worker 响应
worker.onmessage = (e) => {
    clearTimeout(timerId); // 收到响应,取消超时
    console.log('Result:', e.data);
    worker.terminate(); // 任务完成,关闭 Worker
};

// 发送任务
worker.postMessage({ type: 'compute', data: [1, 2, 3] });
如何处理 Worker 内部异常导致的假死
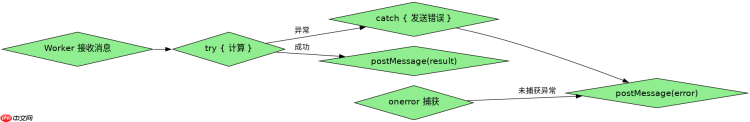
当 Worker 内部发生未捕获的异常或进入死循环时,它可能不会主动发送错误消息,导致主线程的 onmessage 永远无法触发。此时,仅靠超时定时器可能不足以完全解决问题,因为 Worker 进程可能仍在消耗 CPU。更稳健的做法是在 Worker 代码中加入全局错误监听 onerror,使其在出错时向主线程发送特定的错误信号。主线程接收到该信号后,应同样执行清理和超时处理逻辑。这种双向监控机制确保了无论是主线程发起的请求失败,还是 Worker 内部的崩溃,都能被及时识别和处理。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
// worker.js
self.onmessage = function(e) {
    try {
        // 模拟可能出错的计算
        if (e.data.type === 'compute') {
            const result = e.data.data.reduce((a, b) => a + b, 0);
            self.postMessage({ type: 'result', value: result });
        }
    } catch (err) {
        self.postMessage({ type: 'error', message: err.message });
    }
};

self.onerror = function(err) {
    self.postMessage({ type: 'error', message: err.message });
};
基于 postMessage 发送大数组时的内存溢出风险
在使用 postMessage 传输大型数组时,JavaScript 引擎会尝试复制整个数据对象,这可能导致主线程或 Worker 线程的内存瞬间飙升,甚至引发 GC(垃圾回收)停顿,间接造成通信延迟或超时误判。为了避免这种情况,应优先使用 Transferable Objects(可转移对象),如 ArrayBuffer。通过转移所有权而非复制数据,可以显著降低内存开销和通信时间。在实际操作中,将 Uint8Array 或 Float64Array 转换为 ArrayBuffer 并通过第二个参数传递给 postMessage,是实现高效大数据通信的标准做法。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





