






在 java 中通过日志埋点统计业务,核心做法是定义包含业务关键信息的结构化日志格式,并在代码的关键执行路径(如方法入口、出口、异常捕获处)插入日志记录语句。具体实现时,通常使用 slf4j 配合 logback 或 log4j2 作为底层实现,将业务 id、用户 id、操作类型等字段以固定模式输出。这样做可以直接利用日志文件的文本特性进行后续分析,无需引入额外的监控系统即可快速落地业务统计需求。

如何设计支持业务统计的日志格式
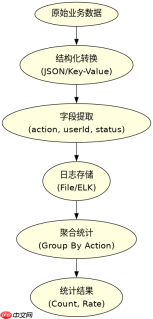
设计支持统计的日志格式需要遵循结构化原则,避免纯文本的自然语言描述。推荐使用 JSON 格式或带有明确分隔符的定长字段格式,确保每个业务指标都有对应的键值对。例如,定义一个包含 traceId、userId、action 和 status 的模板。在实际编码中,通过配置日志框架的模式转换器(Converter)来实现自动化填充,或者在代码中手动构建 JSON 对象。这种格式的优势在于后续可以使用 grep、awk 或 ELK 栈轻松提取特定字段的统计数据,如计算某类操作的总次数或成功率。
{
  "timestamp": "2023-10-27T10:00:00Z",
  "level": "INFO",
  "logger": "com.example.BusinessLogger",
  "message": {
    "action": "ORDER_CREATE",
    "userId": "U123456",
    "orderId": "O987654",
    "amount": 100.50,
    "status": "SUCCESS"
  },
  "traceId": "abc-123-def-456"
}
上述 JSON 结构展示了如何将业务数据嵌入日志。在实际应用中,开发者应确保所有关键字段不为空,并为可能缺失的字段提供默认值。例如,如果用户未登录,userId 可以设为 anonymous。这种一致性对于后续的聚合统计至关重要。此外,建议为不同的业务动作定义不同的日志级别,如正常流程用 INFO,错误流程用 ERROR,以便在统计时区分成功与失败的路径。
如何在代码中高效插入埋点而不影响性能
在代码中插入埋点时,必须考虑性能开销,特别是在高并发场景下。直接调用日志框架的方法可能会因为字符串拼接或条件判断带来额外负担。最佳实践是使用占位符语法(如 SLF4J 的 {}),并配合日志级别开关检查。例如,在记录 DEBUG 或 TRACE 级别的详细业务数据前,先检查 logger.isDebugEnabled()。对于核心的业务统计日志,通常使用 INFO 级别,但可以通过异步 Appender 将日志写入磁盘,从而减少主线程的阻塞时间。这样既保证了数据的完整性,又维持了系统的响应速度。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。

import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import com.fasterxml.jackson.databind.ObjectMapper;

public class BusinessService {
    private static final Logger logger = LoggerFactory.getLogger(BusinessService.class);
    private static final ObjectMapper mapper = new ObjectMapper();

    public void createOrder(String userId, double amount) {
        // 1. 前置检查:确保日志记录不会因级别关闭而产生不必要的字符串拼接开销
        if (logger.isInfoEnabled()) {
            try {
                // 2. 构建结构化业务数据
                String action = "ORDER_CREATE";
                String status = "PROCESSING";

                // 3. 使用占位符传递参数,避免提前格式化
                logger.info("{}|{}|{}|{}|{}",
                    action,
                    userId,
                    amount,
                    status,
                    System.currentTimeMillis());
            } catch (Exception e) {
                // 4. 记录异常但不中断业务流程
                logger.error("Failed to log business event", e);
            }
        }

        // 实际业务逻辑...
    }
}
这段代码演示了如何在 createOrder 方法中安全地插入埋点。首先,通过 isInfoEnabled() 检查来避免在日志被禁用时进行无意义的字符串拼接。其次,使用竖线 | 作为分隔符构建一行简单的结构化日志,这种方式比 JSON 更轻量,且易于使用命令行工具解析。最后,将时间戳纳入日志内容,便于后续按时间窗口进行统计。开发者应注意,不要在循环内部频繁创建日志对象或进行复杂的序列化操作,以免成为性能瓶颈。
基于日志中的状态字段如何统计业务成功率
基于日志中的状态字段统计业务成功率,关键在于统一状态值的定义并建立清晰的过滤规则。在之前的示例中,我们使用了 status 字段来标识业务执行的结果。要计算成功率,需要从海量日志中提取出所有包含目标业务动作(如 ORDER_CREATE)的记录,然后根据 status 的值进行分类计数。通常,SUCCESS 或 COMPLETED 被视为成功,而 FAIL、ERROR 或超时标记被视为失败。通过对比成功次数与总次数,即可得出该业务的成功率。这种方法不依赖应用内存中的计数器,能够反映真实的生产环境流量分布,包括重试和失败后的恢复情况。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


