






Oracle 11g如何解决分区表物化视图刷新慢的性能瓶颈?
在oracle 11g中,解决分区表物化视图刷新慢的核心方法是使用增量快速刷新(fast refresh with incremental materialized view log)并配合并行执行。通过为基表创建包含rowid和sequence的物化视图日志,可以确保刷新时仅处理自上次刷新以来变更的数据行,从而避免全量扫描。同时,启用并行度(parallel)能充分利用多核cpu加速数据转换过程。

如何配置物化视图日志以支持高效增量刷新?
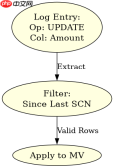
要支持高效的增量刷新,必须为基表创建一个带有ROWID、SEQUENCE和INCLUDING NEW VALUES的物化视图日志。这允许Oracle追踪每一行的具体变化类型(INSERT, UPDATE, DELETE),并在刷新时只应用这些差异。如果缺少SEQUENCE或NEW VALUES,Oracle可能无法正确识别更新操作,导致刷新失败或回退到全量刷新。
-- 创建基表
CREATE TABLE sales_base (
    sale_id NUMBER PRIMARY KEY,
    sale_date DATE,
    amount NUMBER(10,2)
) PARTITION BY RANGE (sale_date) (
    PARTITION p2023 VALUES LESS THAN (TO_DATE('2024-01-01', 'YYYY-MM-DD')),
    PARTITION p2024 VALUES LESS THAN (TO_DATE('2025-01-01', 'YYYY-MM-DD'))
);

-- 创建物化视图日志,关键参数:ROWID, SEQUENCE, INCLUDING NEW VALUES
CREATE MATERIALIZED VIEW LOG ON sales_base
WITH ROWID, SEQUENCE(sale_id, amount) INCLUDING NEW VALUES;

-- 创建物化视图
CREATE MATERIALIZED VIEW mv_sales_fast
BUILD IMMEDIATE
REFRESH FAST ON DEMAND
ENABLE QUERY REWRITE
AS
SELECT s.sale_id, s.sale_date, SUM(s.amount) as total_amount
FROM sales_base s
GROUP BY s.sale_id, s.sale_date;
上述代码创建了分区表sales_base及其对应的MV日志。注意LOG中的SEQUENCE列指定了参与刷新的关键列,而INCLUDING NEW VALUES确保了更新后的值被记录。执行REFRESH FAST命令时,Oracle将仅读取日志中自上次刷新以来的新记录。
并行刷新如何进一步提升性能?
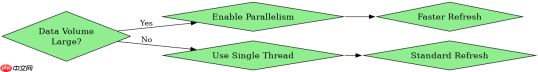
当数据量极大时,即使使用了增量刷新,单线程处理仍可能成为瓶颈。此时,可以在创建物化视图或手动刷新时指定PARALLEL子句。并行刷新会将刷新任务拆分为多个子任务,由多个并行服务器进程同时处理不同分区或数据块。需要注意的是,并行度不宜过高,以免占用过多系统资源影响其他业务。

-- 手动触发并行快速刷新
EXEC DBMS_MVIEW.REFRESH('MV_SALES_FAST', 'F', PARALLELISM => 4);
这里调用DBMS_MVIEW.REFRESH过程,传入物化视图名称'MV_SALES_FAST',刷新模式'F'代表Fast,PARALLELISM => 4表示使用4个并行进程。这种方式比默认的串行刷新显著减少了等待时间,特别是在处理大分区表时效果明显。建议根据服务器CPU核心数调整并行度,通常设置为CPU核心数的1/2到1倍较为合适。
如果基表发生DDL变更,物化视图会怎样?
如果在基表上执行了ALTER TABLE等DDL操作(如添加列、修改数据类型),现有的物化视图可能会失效或需要重新编译。特别是如果DDL改变了参与聚合的关键列结构,增量刷新机制可能无法正常工作。此时,通常需要重新构建物化视图(REFRESH COMPLETE)或重建物化视图日志。因此,在生产环境中进行DDL变更前,应评估对物化视图的影响,并考虑在维护窗口期执行。



