






在 apache 中配置基于域名的虚拟主机静态资源防盗链,核心做法是在 setenvif 提取 referer 头进行判断。具体实现时,需设置合法域名白名单,对未命中白名单的请求返回 403 forbidden 状态码,从而阻止其他网站直接引用你的资源。

如何配置基础 Referer 白名单验证
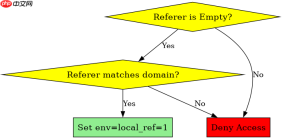
要实现基础的防盗链,需要在虚拟主机配置中定义哪些来源是合法的。Apache 通过环境变量 HTTP_REFERER 获取请求来源,利用 SetEnvIfNoCase 指令可以忽略大小写地匹配域名。对于没有 Referer 头的请求(如浏览器直接访问),通常视为合法;而对于有 Referer 但不在白名单内的请求,则拒绝访问。
<virtualhost>
    ServerName www.example.com
    DocumentRoot /var/www/html

    # 允许空 Referer(直接访问)
    SetEnvIfNoCase Referer "^$" local_ref=1

    # 允许来自自身域名的请求
    SetEnvIfNoCase Referer "^http://www\.example\.com/" local_ref=1

    # 允许来自特定合作伙伴域名的请求
    SetEnvIfNoCase Referer "^http://partner\.site\.com/" local_ref=1

    <directory>
        Options -Indexes
        Order allow,deny
        Allow from env=local_ref
        Deny from all
    </directory></virtualhost>
上述配置中,SetEnvIfNoCase 创建了名为 local_ref 的环境变量。当请求的 Referer 为空或以指定域名开头时,该变量被置为 1。随后在 Allow from env=local_ref 允许设置了该变量的请求通过,而 Deny from all 作为兜底策略拒绝所有其他请求。这种组合确保了只有白名单内的来源才能获取静态资源。
如何针对特定文件类型实施更严格的限制
如果只需要保护图片、视频或压缩包等特定类型的静态资源,可以使用

通过Apache Tika Server REST API从1400多种文件格式中提取文本和元数据。处理PDF、DOCX、PPTX、电子邮件归档以及带有MIME类型检测的嵌入式文档提取。
<virtualhost>
    ServerName www.example.com
    DocumentRoot /var/www/html

    # 定义合法 Referer 列表
    SetEnvIfNoCase Referer "^$" allow_refer=1
    SetEnvIfNoCase Referer "^http://www\.example\.com" allow_refer=1
    SetEnvIfNoCase Referer "^http://cdn\.trusted\.com" allow_refer=1

    # 仅对图片文件进行防盗链检查
    <locationmatch>>
        Order allow,deny
        Allow from env=allow_refer
        Deny from all
        ErrorDocument 403 /error/forbidden.html
    </locationmatch><directory>
        Options -Indexes
        # 其他资源默认允许访问
    </directory></virtualhost>
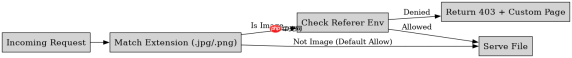
在这个配置中,allow_refer 环境变量的约束。非图像文件(如 HTML、CSS、JS)不受此规则限制,继续由默认的 ErrorDocument 403 指定了当请求被拒绝时返回自定义的 /error/forbidden.html 页面,而不是默认的 Apache 错误页,这有助于品牌一致性或向用户说明情况。
当 Referer 头被客户端故意伪造或缺失时会发生什么
防盗链机制依赖于 HTTP 协议中的 Referer 头,但该字段并非强制要求,且容易被客户端工具或脚本伪造。如果攻击者使用 curl 或 Python 脚本直接请求资源而不发送 Referer 头,根据上述配置中 SetEnvIfNoCase Referer "^$" local_ref=1 的规则,这类请求会被视为合法并放行。这意味着纯基于 Referer 的防盗链无法防御直接链接或恶意爬虫的抓取行为,它主要防范的是普通网页中的标签引用。






