






JDBC 事务中读写分离的核心实现方式
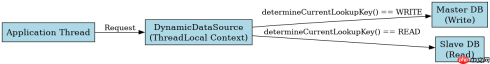
在 jdbc 事务管理中实现读写分离,核心做法是维护两个独立的 connection 对象,分别指向主库(写)和从库(读),并通过 threadlocal 或上下文变量在当前线程内切换数据源。这样可以在同一个业务逻辑中,对写操作使用主库连接,对读操作使用从库连接,从而分担数据库压力。
基于动态数据源的自动路由策略
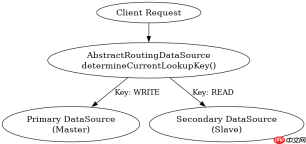
要实现自动化的读写分离,通常不手动切换连接,而是通过继承 AbstractRoutingDataSource 定义一个动态数据源。该数据源会根据当前线程中设置的标记(如 ReadWriteType.WRITE 或 READ)动态决定返回哪个物理连接。开发者只需在写方法前设置标记,框架会自动处理后续的连接获取。

FilePond 灵活的 JavaScript 文件上传库
下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import org.springframework.jdbc.datasource.lookup.AbstractRoutingDataSource;

public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        return DataSourceContextHolder.getDbType();
    }
}

// 使用示例
DataSourceContextHolder.setDbType(DataSourceType.WRITE);
// 执行写操作
DataSourceContextHolder.setDbType(DataSourceType.READ);
// 执行读操作
事务边界内的数据一致性保障
在分布式或异步场景下,读写分离可能导致“脏读”或数据延迟。如果在同一个事务中先写后读,必须确保读操作也发生在主库,否则可能读到旧数据。因此,关键做法是在事务开始时强制将数据源类型设为 WRITE,并在事务提交前保持该状态,直到所有写操作完成后再切换回 READ。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


