






使用 gbk 处理中文文件时,核心做法是在读取和写入环节显式指定 gbk 字符集,以解决默认编码(通常是 utf-8)与文件实际编码不一致导致的乱码问题。具体实现上,推荐使用 inputstreamreader 配合 fileinputstream 进行读取,或使用 outputstreamwriter 配合 fileoutputstream 进行写入,并在构造函数中传入 standardcharsets.gbk 或字符串 "gbk"。这样能确保中文字符被正确解析为字节流,避免跨平台时的编码差异。

如何正确读取 GBK 编码的文本文件
读取 GBK 文件的关键在于将字节流转换为字符流时指定正确的解码器。如果直接使用 BufferedReader 而不指定编码,Java 会使用系统默认编码,这在 Windows 以外的环境或服务器端往往导致中文乱码。通过包装 InputStreamReader 并设置 GBK 编码,可以逐行准确读取内容。以下代码展示了从 data.txt 读取内容的完整过程,该文件假设已用 GBK 编码保存了中文文本。
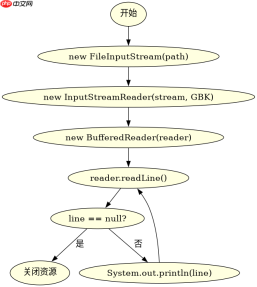
import java.io.BufferedReader;
import java.io.FileInputStream;
import java.io.InputStreamReader;
import java.nio.charset.StandardCharsets;

public class GbkReader {
    public static void main(String[] args) throws Exception {
        // 指定文件路径
        String filePath = "data.txt";

        // 使用 FileInputStream 读取字节流
        // InputStreamReader 负责将字节流按 GBK 编码转换为字符流
        try (BufferedReader reader = new BufferedReader(
                new InputStreamReader(new FileInputStream(filePath), StandardCharsets.GBK))) {

            String line;
            // 逐行读取直到文件结束
            while ((line = reader.readLine()) != null) {
                System.out.println(line);
            }
        }
    }
}
运行上述代码后,控制台会输出文件中存储的中文内容。如果文件不存在,程序会抛出 FileNotFoundException;如果文件编码不是 GBK,输出的中文可能会出现乱码。此方法适用于所有基于字符处理的场景,如日志分析或配置读取。
如何将中文字符串写入 GBK 编码的文件
写入 GBK 文件需要确保输出的字节流符合 GBK 编码规范。同样地,应使用 OutputStreamWriter 作为桥梁,将字符数据转换为字节数据,并明确指定 GBK 编码。这样可以保证生成的文件在 Windows 记事本或其他支持 GBK 的软件中显示正常。下面的代码演示了如何将一段包含中文的字符串写入到 output.txt 中。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
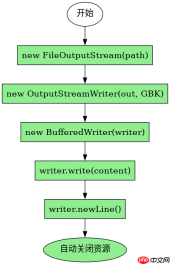
import java.io.BufferedWriter;
import java.io.FileOutputStream;
import java.io.OutputStreamWriter;
import java.nio.charset.StandardCharsets;

public class GbkWriter {
    public static void main(String[] args) throws Exception {
        String filePath = "output.txt";
        String content = "Hello, 世界! This is a test.";

        // 使用 FileOutputStream 写入字节流
        // OutputStreamWriter 负责将字符流按 GBK 编码转换为字节流
        try (BufferedWriter writer = new BufferedWriter(
                new OutputStreamWriter(new FileOutputStream(filePath), StandardCharsets.GBK))) {

            // 写入内容
            writer.write(content);
            // 换行
            writer.newLine();
            writer.write("Another line: 测试中文.");
        }
    }
}
执行该程序后,会在当前目录下生成 output.txt 文件。使用十六进制编辑器查看该文件,可以看到中文字符对应的字节序列符合 GBK 编码规则(例如“世”字对应 CA C7)。这种写入方式确保了数据的持久化存储格式正确,便于后续其他 GBK 兼容工具读取。
当输入文件包含混合编码时会发生什么
如果尝试用 GBK 解码器去读取一个实际是 UTF-8 编码的文件,或者文件中混入了非法的 GBK 字节序列,程序的行为取决于具体的错误处理策略。在上面的示例代码中,如果没有捕获异常,遇到无法解码的字节序列时,InputStreamReader 会抛出 MalformedInputException 或 IOException。这会导致程序中断,无法继续读取后续的有效内容。因此,在处理未知来源的文件时,必须考虑编码检测或容错机制。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


