






mb_strrev()反转中文字符串不乱码
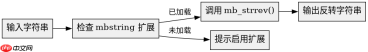
使用php内置的mb_strrev()函数可以安全地反转包含中文的多字节字符串,避免乱码。该函数基于多字节字符集(如utf-8)进行逐字符反转,而非按字节操作。调用时需确保传入的字符串编码与当前环境一致,通常默认处理utf-8编码。若未安装或启用mbstring扩展,则需先通过extension_loaded('mbstring')检查并启用。
$str = "你好世界";
if (extension_loaded('mbstring')) {
    $reversed = mb_strrev($str);
    echo $reversed; // 输出: 界世好你
} else {
    die("请启用 mbstring 扩展");
}
上述代码在启用mbstring后,能正确将"你好世界"反转为"界世好你",无乱码现象。注意:必须保证输入字符串为有效UTF-8编码,否则可能引发警告或错误结果。
手动实现mb_strrev()逻辑
当无法使用mb_strrev()时,可通过preg_split配合正则表达式拆分多字节字符,再逆序拼接实现相同效果。此方法不依赖特定扩展,但性能略低。核心思路是将字符串按Unicode字符边界切分,再反向连接。


使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
$str = "你好世界";
$chars = preg_split('//u', $str, -1, PREG_SPLIT_NO_EMPTY);
$reversed = implode('', array_reverse($chars));
echo $reversed; // 输出: 界世好你
该方案同样适用于任意UTF-8中文混合字符串,且无需额外扩展。关键在于正则//u标志启用Unicode模式,确保每个汉字作为一个独立单元被分割。最终通过array_reverse和implode完成反转,行为与mb_strrev()一致。
非UTF-8编码下反转中文字符串会怎样
若输入字符串非UTF-8编码(如GBK),直接使用mb_strrev()或preg_split('//u')会导致部分字符被误识别或截断,产生乱码或异常输出。例如,GBK编码的"你好"在UTF-8模式下会被拆分为多个非法字节序列,导致mb_strrev()抛出警告或返回不完整结果。因此,必须在反转前统一转换为UTF-8编码,或使用对应编码的多字节函数(如mb_convert_encoding预处理)。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!






