






java iterator 实现流式处理的核心做法是结合 streamsupport.stream() 将迭代器包装为 stream,从而利用 java 8+ 的函数式 api 进行链式操作。具体而言,需要调用 streamsupport.stream(iterator, characteristics) 方法,传入生成的 iterator 实例和适当的 spliterator 特征值(如 spliterator.ordered),这样就能获得一个支持过滤、映射和归约的流对象。若迭代器包含空值或存在并发修改风险,需额外处理以确保数据完整性。

如何将自定义 Iterator 转换为 Stream
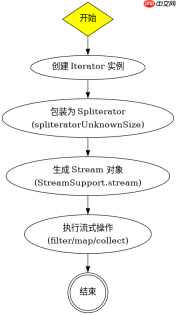
要将任意 Iterator 转换为流,必须使用 java.util.stream.StreamSupport 工具类中的静态方法。关键在于构造正确的 Spliterator,因为 Stream 底层依赖 Spliterator 来支持并行处理和特性推断。通常通过 Spliterators.spliteratorUnknownSize(iterator, characteristics) 创建无大小限制的分割器,再传入 stream() 方法。这样做的好处是无需手动实现复杂的遍历逻辑,直接复用标准库能力。
import java.util.Iterator;
import java.util.Spliterator;
import java.util.Spliterators;
import java.util.stream.Stream;
import java.util.stream.Collectors;

public class IteratorStreamExample {
    public static void main(String[] args) {
        // 模拟一个自定义 Iterator
        Iterator<string> iterator = new Iterator() {
            private int index = 0;
            private String[] data = {"A", "B", "C", "D"};

            @Override
            public boolean hasNext() {
                return index  spliterator = Spliterators.spliteratorUnknownSize(iterator, Spliterator.ORDERED);
        Stream<string> stream = StreamSupport.stream(spliterator, false);

        // 执行流式处理
        String result = stream.filter(s -> s.contains("A") || s.contains("C"))
                              .map(String::toUpperCase)
                              .collect(Collectors.joining(", "));

        System.out.println(result); // 输出: A, C
    }
}</string></string>
如何控制流的并行与顺序执行
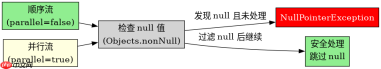
在调用 StreamSupport.stream() 时,第二个参数 parallel 决定了流的执行模式。若传入 true,则生成并行流,适合处理大规模数据集并利用多核 CPU;若传入 false,则为顺序流,保证元素处理的顺序性与 Iterator 提供的顺序一致。对于大多数基于内存集合的迭代器,顺序流更常见且开销更低。若需并行,建议同时设置 Spliterator.CONCURRENT 或 Spliterator.NONNULL 等特征以优化性能。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import java.util.Iterator;
import java.util.Spliterator;
import java.util.Spliterators;
import java.util.stream.Stream;
import java.util.stream.Collectors;

public class ParallelIteratorStream {
    public static void main(String[] args) {
        Iterator<integer> iterator = new Iterator() {
            private int i = 0;
            @Override public boolean hasNext() { return i  spliterator = Spliterators.spliteratorUnknownSize(iterator, Spliterator.ORDERED);

        // 切换此处 true/false 可改变执行模式
        Stream<integer> parallelStream = StreamSupport.stream(spliterator, true);

        long count = parallelStream.filter(n -> n % 2 == 0).count();
        System.out.println("Even numbers count: " + count); // 输出: 500
    }
}</integer></integer>
当 Iterator 返回 null 值时会发生什么
如果 Iterator 的实现允许 next() 返回 null,直接将其转为 Stream 后,流中会包含 null 元素。这可能导致后续操作如 map 或 filter 抛出 NullPointerException。为避免此问题,应在转换前过滤掉 null,或在流管道中使用 Objects.nonNull() 进行筛选。此外,若使用 Spliterator.NONNULL 特征,虽能提示底层优化,但不会自动移除 null,仍需显式处理。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


