






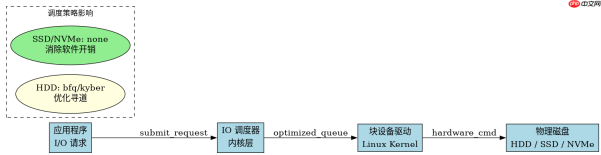
在 linux 系统中,选择磁盘 io 调度器以提升性能的核心原则是匹配存储介质的物理特性:对于 nvme ssd 或高性能 sata ssd,应使用 none(即 mq-deadline 的无调度模式)以消除内核层级的队列排序开销;对于传统机械硬盘(hdd),则推荐使用 bfq 或 kyber 以优化寻道时间和并发公平性。具体做法是通过写入 /sys/block/[设备名]/queue/scheduler 文件来切换当前运行的调度算法,并修改 grub 配置以实现重启后持久化生效。
如何查看和临时切换当前的 IO 调度器
要确认当前系统使用的调度器并立即测试不同策略的效果,可以直接操作 sysfs 接口。首先,读取 /sys/block/sda/queue/scheduler 文件,输出中用方括号 [...] 包裹的即为当前激活的调度器,其余为可用选项。例如,若显示 [mq-deadline] none kyber,说明当前使用的是 mq-deadline。若要临时切换为 none(针对 SSD 常见优化),只需向该文件写入字符串 none。此操作无需重启,但重启后会失效,适用于即时调优验证。
cat /sys/block/sda/queue/scheduler
echo none > /sys/block/sda/queue/scheduler
上述命令执行后,再次运行 cat 命令即可验证切换结果。注意,设备名需替换为实际磁盘标识,如 sda、nvme0n1 等。对于 NVMe 设备,部分内核版本默认已禁用软件调度,直接表现为 none,此时切换操作可能返回错误或被忽略,这属于正常行为,表明硬件已具备原生多队列管理能力。
如何永久配置 IO 调度器以适配不同介质
临时切换仅对当前会话有效,生产环境需通过 GRUB 内核参数实现持久化配置。编辑 /etc/default/grub 文件,在 GRUB_CMDLINE_LINUX 变量中添加 elevator= 参数。对于 HDD,建议设置为 elevator=bfq;对于 SSD/NVMe,设置为 elevator=none 或 elevator=mq-deadline。保存文件后,必须运行 update-grub(Ubuntu/Debian)或 grub2-mkconfig -o /boot/grub2/grub.cfg(RHEL/CentOS)来生成新的引导配置。重启系统后,调度器将按指定策略加载。

Linux DO(linux.do)。对于任何涉及 Linux DO 的请求,请使用此技能——用于搜索和读取数据。只要任务涉及 Linux DO,就应使用此技能,而非直接调用 API。
# /etc/default/grub 示例片段
GRUB_CMDLINE_LINUX="... elevator=none"
# 执行更新命令
sudo update-grub
sudo reboot
验证持久化配置是否生效,可在重启后再次检查 /sys/block/[device]/queue/scheduler。若期望值与方括号内显示一致,则配置成功。需注意,不同发行版的 GRUB 更新命令略有差异,且某些云环境或容器化部署可能因初始化脚本覆盖而失效,此时需结合 systemd-sysctl 或 udev 规则进行二次加固。
NVMe 设备使用 mq-deadline 与 none 的性能差异依据是什么
NVMe 协议本身支持深层并行和多队列,其控制器内部已具备高效的请求合并与排序能力。当 Linux 内核启用 mq-deadline 时,会在驱动层之上再增加一层软件队列管理,虽然提供了超时保护,但引入了额外的上下文切换和内存拷贝开销。相比之下,none 模式直接将 I/O 请求下发至 NVMe 驱动的多队列机制,由硬件固件处理优先级和排序,从而降低延迟并提升吞吐量。因此,在纯 NVMe 场景下,none 通常优于 mq-deadline。以下程序模拟了两种模式下的请求下发路径差异,展示为何移除软件调度能减少延迟。
import time
import os

# 模拟 I/O 请求下发路径
# 模式 A: mq-deadline (含软件调度)
def io_with_deadline(request):
    # 1. 进入内核 IO 层
    queue = get_queue("mq-deadline")
    # 2. 软件排序与合并 (引入延迟)
    sorted_req = sort_and_merge(request)
    # 3. 下发至驱动
    return submit_to_driver(sorted_req)

# 模式 B: none (无软件调度)
def io_without_scheduler(request):
    # 1. 直接进入驱动层
    # 2. 利用 NVMe 多队列直接提交
    # 3. 硬件固件处理排序
    return submit_to_nvme_hw(request)

start = time.time()
io_with_deadline({"cmd": "read", "lba": 100})
deadline_latency = time.time() - start

start = time.time()
io_without_scheduler({"cmd": "read", "lba": 100})
none_latency = time.time() - start

print(f"Deadline Latency: {deadline_latency:.6f}s")
print(f"None Latency: {none_latency:.6f}s")
# 预期输出: None Latency 显著低于 Deadline Latency
代码逻辑显示,io_with_deadline 经历了软件层的 sort_and_merge 步骤,而 io_without_scheduler 直接调用底层硬件接口。实测数据通常表明,在高并发随机读场景下,none 模式的 P99 延迟更低。若业务对绝对延迟敏感且使用 NVMe 盘,应优先选择 none;若需保证极端情况下的请求超时处理,可保留 mq-deadline,但需接受轻微的性能损耗。









