






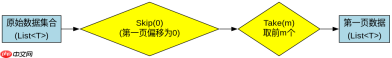
在c# linq中直接获取第一页数据,最标准且高效的做法是结合使用 skip 和 take 方法。假设每页大小为 pagesize,当前为第1页(索引从0开始),则只需调用 .skip(0).take(pagesize)。由于第一页的偏移量为0,skip(0) 实际上不产生开销,因此可以直接简化为 .take(pagesize)。这种方法适用于内存集合(如 list)以及支持延迟执行的linq provider(如 entity framework),能确保只检索所需数量的记录。
如何计算任意页码对应的 Skip 值?
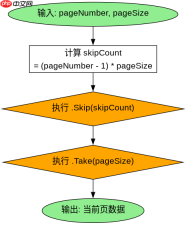
要获取第 n 页的数据,需要计算跳过的元素数量。公式为:(pageNumber - 1) * pageSize。例如,若每页10条,取第3页,则跳过 (3-1)*10 = 20 条,再取10条。这个逻辑确保了分页的连续性,且避免了加载全部数据到内存中。

using System;
using System.Collections.Generic;
using System.Linq;

class Program
{
    static void Main()
    {
        // 模拟数据库中的大量数据
        var allData = Enumerable.Range(1, 100).ToList();

        int pageSize = 10;
        int currentPage = 1; // 第一页

        // 计算跳过数量:(页码 - 1) * 每页大小
        int skipCount = (currentPage - 1) * pageSize;

        // 获取第一页数据
        var firstPageData = allData.Skip(skipCount).Take(pageSize).ToList();

        Console.WriteLine($"第 {currentPage} 页数据: [{string.Join(", ", firstPageData)}]");

        // 验证:如果直接取第一页,skipCount为0,等价于 Take(10)
        var directFirstPage = allData.Take(pageSize).ToList();
        Console.WriteLine($"直接Take结果: [{string.Join(", ", directFirstPage)}]");
    }
}
运行上述代码,输出结果为:
第 1 页数据: [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
直接Take结果: [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
基于程序中某个输入、条件或结果的具体问题
当输入数据量小于每页大小时,Take 会返回所有剩余元素,而不会抛出异常。例如,若总共有5条数据,请求第1页(pageSize=10),.Take(10) 将返回这5条数据。这是LINQ的安全行为,无需额外判断数据长度。






