






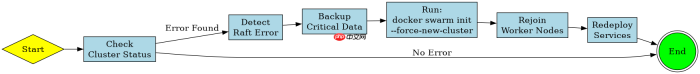
修复 docker swarm 集群 raft 数据库损坏的核心方法是使用 docker swarm init --force-new-cluster 命令强制重建集群状态,该操作会清除所有现有的 swarm 元数据并初始化一个新的空集群。执行此命令后,集群将恢复可用状态,但之前通过 swarm 模式部署的所有服务、网络和卷配置都会丢失,需要重新定义和部署这些资源。在操作前,建议先备份节点上的关键配置文件和数据卷,以防数据不可逆丢失。
如何强制重置 Swarm 集群状态
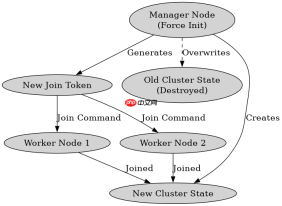
当 Raft 日志损坏或无法达成共识时,管理员可以通过强制初始化新集群来绕过损坏的数据库。这一过程会覆盖当前节点的 /var/lib/docker/swarm 目录下的状态文件,使集群进入初始状态。执行成功后,当前节点将成为新的 Manager,其他节点需要重新加入。
sudo docker swarm init --force-new-cluster
上述命令执行后,终端会输出一段包含 docker swarm join-token manager 的提示文本。此时,原集群中的 Worker 节点将无法识别新的 Manager ID,必须从这些节点上运行 docker swarm leave 退出旧集群,然后使用新生成的 Join Token 重新加入。如果节点处于 NotReachable 状态,可能需要先在 Manager 节点上使用 docker node rm 清理残留节点记录。此步骤确保了集群状态的干净重置,消除了因 Raft 日志不一致导致的锁死问题。
如何重新加入节点并恢复服务
在强制重置集群后,恢复工作的重点是将 Worker 节点重新接入新的 Swarm 环境,并重新部署之前的服务定义。由于 Raft 数据库已清空,所有服务配置不会自动恢复,必须手动或通过编排文件重新应用。这一步骤验证了集群通信是否恢复正常,并确认数据持久化机制(如 Volume)是否完好。

Drizzle ORM 是一个轻量级的 TypeScript ORM,提供类型安全的 SQL 模式声明、关系型和类 SQL 查询构建器,以及自动生成迁移。其压缩后仅 7.4kb,且无依赖项,支持 PostgreSQL、MySQL 和 SQLite,包括 Neon、Turso 和 Cloudflare D1 等无服务器数据库。
# 在 Worker 节点上执行
docker swarm leave --force

# 在 Manager 节点上获取新的 Join Token
docker swarm join-token worker

# 在 Worker 节点上执行重新加入
docker swarm join --token <new_token><manager_ip>:2377

# 在 Manager 节点上重新部署服务
docker service create --name my-app --replicas 2 -p 80:80 nginx
</manager_ip></new_token>
重新加入节点后,通过 docker node ls 检查所有节点状态是否为 Ready。接着,使用 docker stack deploy 或逐个 docker service create 命令恢复业务服务。对于挂载了本地路径或命名卷的服务,需确保存储驱动正常,因为 Raft 损坏不影响底层文件系统数据,仅影响调度元数据。若发现服务启动失败,应检查日志以排除端口冲突或资源不足问题,而非归咎于 Raft 状态。
Raft 损坏后数据卷是否安全
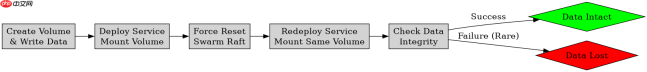
在强制重置集群后,用户最关心的是存储在 Docker Volume 或绑定挂载中的数据是否受损。Raft 数据库仅存储集群的配置元数据(如服务定义、网络配置、密钥等),并不存储实际的业务数据。因此,即使 Raft 数据库完全损坏并被重置,挂载在容器内的数据卷内容通常保持完整。这一结论基于 Docker 的架构设计,其中状态平面与数据平面是分离的。
为了验证这一点,可以在重置前创建一个包含测试数据的命名卷,并在重置后重新部署一个使用该卷的服务。如果服务能正常读取到之前的数据,则证明数据安全性。例如,创建一个名为 data-vol 的卷,写入文件,执行 docker swarm init --force-new-cluster,然后重新创建挂载该卷的容器。只要存储后端(如 local driver)未受损,数据即可恢复访问。这强调了定期备份重要数据的重要性,尽管 Raft 恢复本身不威胁数据持久性,但人为操作失误可能导致意外删除。


