






在 docker swarm 中配置 elk 集中式日志系统,核心做法是利用 docker 原生的 json-file 或 journald 日志驱动配合 fluentd/fluent bit 进行采集,并将数据转发至 elasticsearch。具体实施时,需为每个节点部署日志采集器 daemonset(通过全局服务实现),确保所有容器的标准输出被捕获并发送;同时,elasticsearch 和 kibana 作为有状态或无状态服务运行在集群中,通过 overlay 网络互通。这样做能实现跨节点的日志统一收集、存储与可视化,且无需修改业务容器代码。
如何设计 ELK 组件的 Swarm 服务拓扑
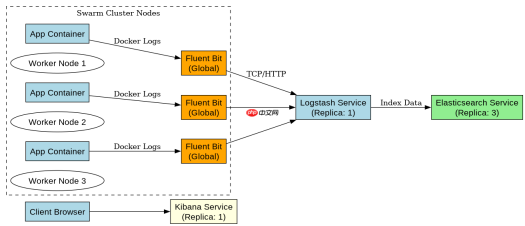
ELK 栈在 Swarm 中的部署通常分为三层:采集层、存储层和展示层。采集层使用全局模式(mode: global)部署 Fluentd 或 Fluent Bit,确保每个 Worker 节点上都有一个实例运行,负责抓取该节点上所有容器的日志文件。存储层由 Elasticsearch 组成,建议至少三个副本以保障高可用,并使用持久化卷挂载数据目录。展示层由 Kibana 提供,通常只需一个副本,通过负载均衡暴露端口。这种拓扑结构利用了 Swarm 的服务发现机制,各组件间通过内部网络通信,对外仅暴露 Kibana 的 HTTP 端口。
version: '3.8'

services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:7.15.0
    environment:
      - discovery.type=single-node
      - xpack.security.enabled=false
    volumes:
      - es_data:/usr/share/elasticsearch/data
    networks:
      - elk-net
    deploy:
      mode: replicated
      replicas: 1

  logstash:
    image: docker.elastic.co/logstash/logstash:7.15.0
    volumes:
      - ./logstash.conf:/usr/share/logstash/pipeline/logstash.conf:ro
    networks:
      - elk-net
    deploy:
      mode: replicated
      replicas: 1

  kibana:
    image: docker.elastic.co/kibana/kibana:7.15.0
    environment:
      - ELASTICSEARCH_HOSTS=http://elasticsearch:9200
    ports:
      - "5601:5601"
    networks:
      - elk-net
    deploy:
      mode: replicated
      replicas: 1

volumes:
  es_data:

networks:
  elk-net:
    driver: overlay
上述 `docker-compose.yml` 定义了一个最小化的 ELK 栈。Elasticsearch 配置为单节点模式以简化初始部署,关闭了安全认证以便快速测试。Logstash 挂载了本地配置文件,用于定义输入、过滤和输出规则。Kibana 通过环境变量指向 Elasticsearch 的内部地址。所有服务都连接到了名为 `elk-net` 的 Overlay 网络,这是 Swarm 集群特有的网络驱动,允许不同节点上的容器相互通信。数据卷 `es_data` 确保了索引数据在容器重启后不丢失。

「在我电脑上明明能跑」——因为少了Docker。帮你写Dockerfile、构建镜像、配置多环境、编排docker-compose,从本地开发到服务器部署一条龙。支持Node.js/Python/Go/Java/前端全栈,覆盖CI/CD集成、安全加固、监控告警,告别环境不一致的噩梦。 触发词:Docker部署、容...
如何实现跨节点的全局日志采集
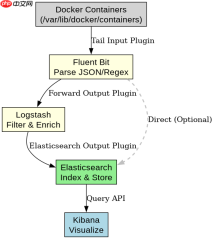
要实现真正的集中式日志,必须在每个 Swarm 节点上运行日志采集代理。在 Swarm 中,这通过创建具有 `mode: global` 的服务来实现。推荐使用 Fluent Bit 或 Vector 等轻量级代理,它们可以直接读取 Docker 的日志文件(位于 `/var/lib/docker/containers/`)。配置的关键在于让代理识别哪些日志属于当前节点,并将其发送到 Logstash 或 Elasticsearch。需要设置环境变量指定目标服务器的地址,并利用 Swarm 的约束条件确保服务调度到所有可用节点。此外,为了性能考虑,通常会先发送到 Logstash 进行预处理,再写入 ES,或者直接写入 ES 如果负载不高。
version: '3.8'

services:
  fluentbit:
    image: fluent/fluent-bit:1.8
    volumes:
      - /var/lib/docker/containers:/var/lib/docker/containers:ro
      - /var/run/docker.sock:/var/run/docker.sock:ro
      - ./fluentbit.conf:/fluent-bit/etc/fluent-bit.conf:ro
    networks:
      - elk-net
    deploy:
      mode: global
      resources:
        limits:
          memory: 128M
        reservations:
          memory: 64M

networks:
  elk-net:
    driver: overlay
这个片段展示了 Fluent Bit 服务的定义。它挂载了 Docker 容器日志目录和 Socket,使其能够动态发现新创建的容器并读取其日志。`mode: global` 确保该服务会在集群中的每一个节点上启动一个实例。资源限制防止单个节点的日志流量过高影响宿主机器性能。配置文件 `fluentbit.conf` 需要配置 `[SERVICE]` 和 `[INPUT]` 以监听 Docker 日志,以及 `[OUTPUT]` 将数据推送到上一节定义的 Logstash 服务地址。这种配置实现了无侵入式的日志采集,业务容器无需任何特殊配置即可被监控。
如何处理 Elasticsearch 集群的高可用与数据持久化
在生产环境中,Elasticsearch 不能仅依赖单副本,必须配置多节点集群以保证高可用性。Swarm 支持通过增加 `replicas` 数量来扩展 ES 服务,但 ES 本身有主从选举机制,需要正确的配置才能形成集群。关键在于共享存储或独立的数据卷策略。如果使用独立数据卷,每个副本拥有独立数据,无法同步;因此推荐方案是使用外部存储后端(如 NFS、EBS 或专用分布式文件系统)挂载到所有 ES 实例,或者使用 ES 官方推荐的 StatefulSet 模式(在 Swarm 中通过多个独立服务模拟)。另外,需调整 `discovery.seed_hosts` 和 `cluster.initial_master_nodes` 等参数,使多个 ES 容器能互相发现并组成集群。同时,应配置健康检查以确保只有健康的节点接收流量。


