






在go-zero框架中集成clickhouse分析业务日志,核心做法是利用go-zero的中间件机制拦截http请求,将关键上下文数据异步推送到消息队列或直接批量写入clickhouse。具体实现时,需要定义一个包含requestid、method、path、status和duration等字段的结构体,通过自定义middleware捕获这些信息,并使用clickhouse驱动(如clickhouse-go)建立连接池进行非阻塞插入。这样做既能保证主业务逻辑的低延迟,又能完整记录请求链路数据供后续分析。

如何设计日志采集的中间件结构
设计日志采集中间件的关键在于解耦业务逻辑与日志记录,同时确保上下文的正确传递。通常的做法是创建一个实现了core.Middleware签名的函数,该函数接收下一个处理函数并返回一个新的处理函数。在这个新处理函数中,使用time.Now()记录开始时间,调用next(ctx)执行实际业务,获取响应状态码后计算耗时,最后将这些信息封装成结构体对象。为了避免阻塞主流程,应将日志发送操作放入独立的Goroutine或通过Channel发送给后台Worker处理。
package middleware

import (
    "context"
    "net/http"
    "time"

    "github.com/zeromicro/go-zero/core/logx"
    "github.com/zeromicro/go-zero/rest/handler"
)

type LogEntry struct {
    RequestID string
    Method    string
    Path      string
    Status    int
    Duration  time.Duration
    IP        string
}

func ClickHouseLogMiddleware(next http.HandlerFunc) http.HandlerFunc {
    return func(w http.ResponseWriter, r *http.Request) {
        start := time.Now()
        // 模拟获取RequestID,实际项目中可能从Header或TraceContext获取
        reqID := r.Header.Get("X-Request-ID")
        if reqID == "" {
            reqID = generateUUID()
        }

        // 包装ResponseWriter以获取状态码
        rw := &statusResponseWriter{ResponseWriter: w, status: http.StatusOK}

        next(rw, r)

        duration := time.Since(start)

        entry := &LogEntry{
            RequestID: reqID,
            Method:    r.Method,
            Path:      r.URL.Path,
            Status:    rw.status,
            Duration:  duration,
            IP:        r.RemoteAddr,
        }

        // 异步发送,不阻塞主流程
        go sendToClickHouse(entry)
    }
}

type statusResponseWriter struct {
    http.ResponseWriter
    status int
}

func (srw *statusResponseWriter) WriteHeader(statusCode int) {
    srw.status = statusCode
    srw.ResponseWriter.WriteHeader(statusCode)
}

// 占位函数,实际需对接CH客户端
func sendToClickHouse(entry *LogEntry) {
    logx.Info("Sending log to CH:", entry)
}

func generateUUID() string {
    return "uuid-placeholder"
}
上述代码展示了中间件的基本骨架。它拦截了所有经过的HTTP请求,记录了请求的方法、路径、IP以及响应状态码。通过自定义的statusResponseWriter结构体,我们能够在请求结束后准确获取到HTTP状态码,这是评估接口健康度的重要指标。异步发送的逻辑确保了即使ClickHouse服务暂时不可用或写入较慢,也不会影响当前API的正常响应。
如何实现高效的批量写入策略
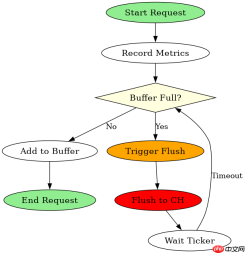
直接向ClickHouse逐条插入日志会导致严重的性能瓶颈和网络开销,因此必须采用批量写入策略。最佳实践是在内存中维护一个缓冲区,当缓冲区达到一定大小(例如1000条)或达到时间间隔(例如1秒)时,触发一次批量插入操作。可以使用Go的sync.Pool来管理缓冲区对象,减少GC压力,同时结合Ticker和Chan来实现定时刷新。此外,还需要处理重试机制和错误日志,防止因网络抖动导致数据丢失。

package writer

import (
    "context"
    "database/sql"
    "fmt"
    "sync"
    "time"

    "github.com/zeromicro/go-zero/core/logx"
)

type BatchWriter struct {
    db     *sql.DB
    buffer []*LogEntry
    mu     sync.Mutex
    size   int
    flushC chan struct{}
}

func NewBatchWriter(db *sql.DB, batchSize int) *BatchWriter {
    bw := &BatchWriter{
        db:     db,
        buffer: make([]*LogEntry, 0, batchSize),
        size:   batchSize,
        flushC: make(chan struct{}, 1),
    }
    go bw.flushLoop()
    return bw
}

func (bw *BatchWriter) Add(entry *LogEntry) {
    bw.mu.Lock()
    defer bw.mu.Unlock()
    bw.buffer = append(bw.buffer, entry)
    if len(bw.buffer) >= bw.size {
        select {
        case bw.flushC  0 {
            result += sep
        }
        result += s
    }
    return result
}
这段代码实现了一个简单的批量写入器。NewBatchWriter初始化时会启动一个后台协程,监听时间Ticker和信号量Channel。当添加日志条目时,如果缓冲区满,则发送信号触发立即刷新;否则等待Ticker超时。这种混合触发机制既保证了数据的实时性,又避免了频繁的小批次写入。在实际生产环境中,推荐使用github.com/ClickHouse/clickhouse-go/v2库提供的Block写入接口,它能更好地利用ClickHouse的列式存储特性,显著提升吞吐量。
ClickHouse表结构应如何设计以支持高效查询
为了支持高效的日志分析,ClickHouse的表结构设计至关重要。推荐使用MergeTree引擎族,并根据查询模式选择合适的排序键(Order By)。通常建议按created_at或date字段排序,以便快速范围扫描。对于高频查询条件如path或status,可以考虑将其加入排序键或使用Skip Indexes。分区策略一般按月或按天进行,便于数据管理和清理。此外,设置合理的TTL(Time To Live)可以自动清理过期日志,节省存储空间。
-- 创建数据库
CREATE DATABASE IF NOT EXISTS logs;

-- 创建日志表
CREATE TABLE IF NOT EXISTS logs.business_logs
(
    request_id String,
    method String,
    path String,
    status UInt16,
    duration UInt64 COMMENT 'Duration in microseconds',
    ip String,
    created_at DateTime DEFAULT now()
)
ENGINE = MergeTree()
PARTITION BY toYYYYMM(created_at)
ORDER BY (created_at, path)
TTL created_at + INTERVAL 30 DAY;

-- 创建物化视图用于聚合统计(可选)
CREATE MATERIALIZED VIEW IF NOT EXISTS logs.business_logs_agg
ENGINE = AggregatingMergeTree()
PARTITION BY toYYYYMM(created_at)
ORDER BY (toStartOfHour(created_at), path, status)
AS SELECT
    toStartOfHour(created_at) AS hour,
    path,
    status,
    count() AS cnt,
    avg(duration) AS avg_duration
FROM logs.business_logs
GROUP BY hour, path, status;
上述DDL语句定义了一个典型的日志表结构。ORDER BY (created_at, path)确保了数据按时间和路径有序存储,这对于查询特定时间段内某个接口的日志非常高效。分区字段toYYYYMM(created_at)将数据按月物理隔离,方便后续按月份删除旧数据。TTL设置保留了最近30天的数据,超出部分自动删除。物化视图business_logs_agg预计算了每小时的接口调用次数和平均耗时,使得Dashboard展示和趋势分析无需全表扫描,极大提升了查询速度。












