






在zhenzhen ai中制作较长的连续片段,可以把内容拆成多个视频节点,先生成第一段,再取它的尾帧作为下一段的参考画面,按顺序逐段推进。需要已能使用无限画布和muse video模型;这种方法是分段生成与衔接,不能理解为一次请求就生成任意长度的视频。
先准备统一参考,再建视频节点
打开无限画布,在空白区域创建图片节点,上传自己的角色、产品或场景参考。需要固定主体时,可先用图片生成节点整理参考资料,再传给后续视频节点。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
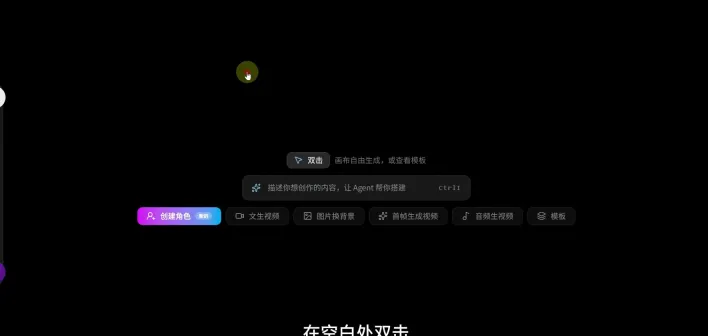
无限画布中的创建节点入口
参考图应服务于同一主体和风格。不要在每段都更换外形、服装或核心场景设定;产品视频同样要检查形状、颜色和标识是否延续。
明确第一段的动作与结束状态
新建视频节点,选择Muse Video,并按实际界面设置时长和画幅。可以先从10秒短片段开始,把重点放在一个清楚的动作或一次观察过程。
视频节点的时长与画幅设置
提示词先写主体在什么地方、正在做什么、镜头如何移动,最后说明结束时的状态。自然语言输入后仍应核对整理出的提示词,删掉与当前镜头无关的动作,避免一个片段承担过多变化。

用前一段尾帧接下一段
第一段完成后,使用视频节点提供的截取尾帧功能,把结束画面作为下一段的参考,再创建后续视频节点。下一段从这个状态继续写动作,不重新描述一个与上一段无关的开场。

截取尾帧与图像处理工具栏
衔接时继续沿用同一画幅和主体设定。前一段尾帧已出现变形、遮挡或不合适构图时,先返工前一段,再继续生成,避免错误被连续传下去。
拼接前先看接缝
把相邻两段连起来播放,重点看主体外形、位置、运动方向和光线是否突然变化。首尾画面相近也不代表动作速度自然,必要时调整下一段的起始动作或重新生成。
逐段合格后再拼接和导出,保留节点与对应文件顺序。实际用量和费用以账号生成界面为准,不把单次示例价格当成固定成本。












