






排查 java 内存泄漏时,利用 ttl(time-to-live)缓存清理机制可以有效防止因对象长期驻留导致的堆内存溢出。具体做法是引入支持自动过期的本地缓存库(如 caffeine),在构建缓存实例时设置全局或局部的过期策略,这样缓存会在达到 ttl 后自动移除条目,从而释放底层对象的引用。若需针对特定业务场景优化,可结合自定义的 key 生成逻辑和动态 ttl 配置,确保高频访问但生命周期短的对象及时回收,避免无效数据堆积。

Caffeine 缓存如何配置全局 TTL 过期
使用 Caffeine 库时,通过 expireAfterWrite 方法可以统一设置所有条目的写入后过期时间。该配置会启动后台线程或惰性检查,在读取或写入时触发清理任务,将超过指定时间的 Entry 从内存中移除。这种方式适用于大多数通用场景,无需手动干预即可维持缓存大小稳定。
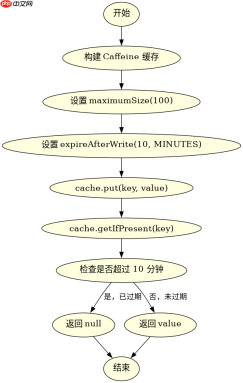
import com.github.benmanes.caffeine.cache.Cache;
import com.github.benmanes.caffeine.cache.Caffeine;
import java.util.concurrent.TimeUnit;

public class GlobalTtlExample {
    public static void main(String[] args) {
        Cache<string string> cache = Caffeine.newBuilder()
                .maximumSize(100)
                .expireAfterWrite(10, TimeUnit.MINUTES)
                .build();

        cache.put("key1", "value1");
        System.out.println(cache.getIfPresent("key1"));
    }
}</string>
运行上述代码,控制台会输出 value1。由于设置了 10 分钟的写后过期时间,如果在 10 分钟内再次访问 key1,仍能获取到值;超过时间后,getIfPresent 将返回 null。这种机制确保了即使没有主动删除操作,旧数据也会随时间推移被清理,减少内存占用。
如何根据业务条件设置局部 TTL
当不同业务数据的生命周期差异较大时,可以使用 expireAfter 方法传入一个 Expiry 接口实现类,为每个 Key-Value 对计算独立的过期时间。例如,对于临时会话数据可设置较短 TTL,而对于基础字典数据则设置较长 TTL。这种方式提供了更细粒度的控制,能够根据实际业务需求动态调整缓存保留时长。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。

import com.github.benmanes.caffeine.cache.Cache;
import com.github.benmanes.caffeine.cache.Caffeine;
import com.github.benmanes.caffeine.cache.Expiry;
import java.time.Duration;
import java.util.concurrent.TimeUnit;

public class LocalTtlExample {
    public static void main(String[] args) {
        Expiry<string string> expiry = (key, value, currentDuration, currentTimestamp, newDuration, newTimestamp) -> {
            if (key.startsWith("session_")) {
                return Duration.ofMinutes(5);
            } else {
                return Duration.ofHours(1);
            }
        };

        Cache<string string> cache = Caffeine.newBuilder()
                .expireAfter(expiry)
                .build();

        cache.put("session_user1", "data1");
        cache.put("dict_city", "Beijing");
    }
}</string></string>
在上述示例中,以 session_ 开头的 Key 会被赋予 5 分钟的过期时间,而其他 Key 则为 1 小时。Caffeine 会在内部记录每个条目的到期时间戳,并在后续操作中判断是否过期。这种基于条件的局部 TTL 设置,使得开发者可以根据数据的重要性与更新频率灵活管理内存资源,避免一刀切策略带来的性能浪费或数据陈旧问题。
缓存清理线程对 CPU 的影响是什么
Caffeine 的清理机制默认采用异步方式,不会阻塞主线程。它使用一个单独的线程池来执行清理任务,或者在读写操作中惰性检查过期条目。因此,即使缓存规模较大,也不会显著增加主线程的负担。不过,如果频繁触发清理任务,可能会引起轻微的 CPU 波动,尤其是在高并发场景下。建议根据实际负载调整最大缓存大小和清理频率,以平衡内存利用率与系统性能。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


