






使用 bufferedinputstream 提升读取性能的核心做法是包装底层字节流并指定合适的缓冲区大小,从而减少系统调用次数。具体实现时,将目标 inputstream 传入 bufferedinputstream 的构造函数中,默认缓冲区大小为 8192 字节(8kb),也可根据实际数据块大小自定义该参数。这样做会将多次小批量读取合并为少量大批量读取,显著降低 i/o 开销。

如何正确初始化 BufferedInputStream 以启用缓冲机制
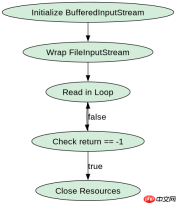
必须通过构造函数将原始输入流作为参数传入,才能激活内部缓冲逻辑。若直接实例化而不关联流,或错误地传递 null,将无法进行有效读取。正确的做法是在创建对象时传入如 FileInputStream 等具体实现类,并确保在 try-with-resources 中管理生命周期以避免资源泄漏。
import java.io.BufferedInputStream;
import java.io.FileInputStream;
import java.io.IOException;
import java.io.InputStream;

public class BufferDemo {
    public static void main(String[] args) throws IOException {
        String filePath = "test.bin";
        // 创建文件输入流并包装为缓冲输入流
        try (InputStream fis = new FileInputStream(filePath);
             BufferedInputStream bis = new BufferedInputStream(fis)) {

            byte[] buffer = new byte[1024];
            int bytesRead;
            while ((bytesRead = bis.read(buffer)) != -1) {
                // 处理读取到的数据
            }
        }
    }
}
缓冲区大小对读取性能的具体影响是什么
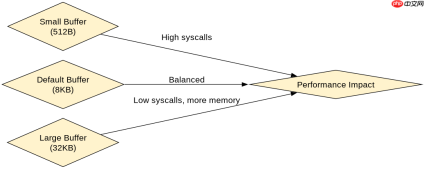
缓冲区大小直接影响内存占用与系统调用频率之间的平衡。过小会导致频繁触发 native read 调用,过大则可能浪费内存且无额外收益。通常建议设置为 8KB 到 64KB 之间,对于顺序读取大文件场景,8192 字节是 JVM 默认值,多数情况下已足够优化性能。若已知数据块较小(如网络小包),可适当调低至 512~1024 字节;若处理超大连续流,可尝试增大至 32768 以上。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import java.io.BufferedInputStream;
import java.io.FileInputStream;
import java.io.IOException;
import java.io.InputStream;

public class BufferSizeCompare {
    public static void main(String[] args) throws IOException {
        String filePath = "large_file.dat";
        long start, end;

        // 测试不同缓冲区大小的性能差异
        for (int size : new int[]{512, 1024, 8192, 32768}) {
            start = System.nanoTime();
            try (InputStream is = new BufferedInputStream(new FileInputStream(filePath), size)) {
                byte[] buf = new byte[1024];
                while (is.read(buf) != -1) {}
            }
            end = System.nanoTime();
            System.out.println("Buffer size: " + size + " -> Time: " + (end - start) / 1e6 + " ms");
        }
    }
}
当读取操作返回 -1 时意味着什么
当 read() 方法返回 -1 时,表示已达到输入流的末尾,没有更多数据可供读取。这是正常结束信号,不应视为错误或异常。开发者应在循环条件中检查此返回值,并在到达末尾后安全关闭流。若在非预期位置出现 -1,需排查源文件是否截断、网络连接是否中断或编码转换是否出错。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



