






spring boot 全局异常处理无法直接捕获消费积压异常,因为消息积压是 kafka 或 rabbitmq 等中间件层面的状态指标,而非 java 运行时抛出的异常对象。要解决这一问题,需要绕过 @controlleradvice 机制,转而通过定时任务轮询消费者 lag(滞后量)指标,并在超过阈值时触发特定的业务逻辑。
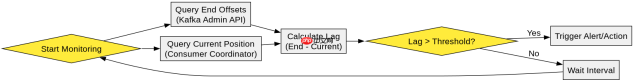
如何配置并获取消费者的实时 Lag 数据
必须引入 KafkaAdmin 或 KafkaConsumer 的 API 来主动查询分区偏移量,而不是依赖被动的事件通知。通过调用 endOffsets() 获取当前生产端的最新位置,并与 position() 获取的消费端当前位置进行比对,计算出每个分区的积压数量。
import org.apache.kafka.clients.admin.AdminClient;
import org.apache.kafka.clients.admin.ListOffsetsResult;
import org.apache.kafka.clients.admin.OffsetSpec;
import org.apache.kafka.common.TopicPartition;

import java.time.Duration;
import java.util.Collection;
import java.util.Map;
import java.util.HashMap;

public class LagMonitor {
    private final AdminClient adminClient;

    public LagMonitor(AdminClient adminClient) {
        this.adminClient = adminClient;
    }

    public Map<topicpartition long> getLagMap(String topic, Collection<topicpartition> partitions) {
        // 1. 获取生产端最新偏移量
        Map<topicpartition offsetspec> latestSpec = new HashMap();
        for (TopicPartition tp : partitions) {
            latestSpec.put(tp, OffsetSpec.LATEST_SPEC);
        }
        ListOffsetsResult latestResult = adminClient.listOffsets(latestSpec);

        // 2. 获取消费端当前偏移量 (需结合 ConsumerCoordinator 或手动维护)
        // 此处简化为假设已知当前消费位置 map: currentPositions
        Map<topicpartition long> currentPositions = getCurrentPositions();

        Map<topicpartition long> lagMap = new HashMap();
        try {
            Map<topicpartition org.apache.kafka.clients.admin.listoffsetsresult.listoffsetinfo> latestOffsets = latestResult.all().get();
            for (Map.Entry<topicpartition org.apache.kafka.clients.admin.listoffsetsresult.listoffsetinfo> entry : latestOffsets.entrySet()) {
                TopicPartition tp = entry.getKey();
                long endOffset = entry.getValue().offset();
                long currentOffset = currentPositions.getOrDefault(tp, 0L);
                lagMap.put(tp, Math.max(0, endOffset - currentOffset));
            }
        } catch (Exception e) {
            throw new RuntimeException("Failed to fetch lag", e);
        }
        return lagMap;
    }

    private Map<topicpartition long> getCurrentPositions() {
        // 实际实现中应从 ConsumerCoordinator 内部状态或自定义计数器获取
        return new HashMap();
    }
}
</topicpartition></topicpartition></topicpartition></topicpartition></topicpartition></topicpartition></topicpartition></topicpartition>
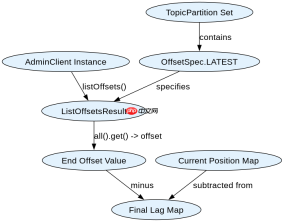
上述代码展示了核心计算逻辑。关键在于 ListOffsetsResult 返回的是异步结果,必须通过 .get() 阻塞获取。计算出的 Lag 即为该分区内未消费的消息条数。开发者需要将此逻辑封装在 Spring 的 @Scheduled 任务中,定期执行以监控整体积压情况。
如何在检测到积压后触发降级或告警策略
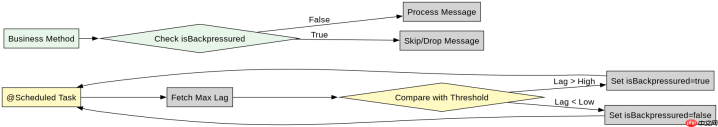
当监控到 Lag 超过设定阈值(例如 1000 条)时,不应尝试重启消费者,而应切换至降级模式。具体做法是在服务层注入一个标志位,当积压严重时,将标志位置为 true,并在业务方法入口处检查该标志位。如果处于降级状态,则直接返回默认值或丢弃非关键数据,从而释放消费者线程去追赶进度。

import org.springframework.scheduling.annotation.Scheduled;
import org.springframework.stereotype.Component;

@Component
public class BackpressureHandler {

    private static final long LAG_THRESHOLD = 1000L;
    private volatile boolean isBackpressured = false;
    private final LagMonitor lagMonitor;

    public BackpressureHandler(LagMonitor lagMonitor) {
        this.lagMonitor = lagMonitor;
    }

    @Scheduled(fixedRate = 5000) // 每5秒检查一次
    public void checkAndReact() {
        // 模拟获取所有相关分区的 Lag
        // 实际项目中需遍历所有订阅的 Topic 和 Partition
        Map<topicpartition long> lags = lagMonitor.getLagMap("my-topic", getAllPartitions());

        long maxLag = lags.values().stream()
                .mapToLong(Long::longValue)
                .max()
                .orElse(0);

        if (maxLag > LAG_THRESHOLD && !isBackpressured) {
            triggerBackpressure();
        } else if (maxLag <p>这段代码定义了一个定时任务,它持续监控积压量。一旦触发 <code>triggerBackpressure</code>,业务逻辑中的 <code>isBackpressured</code> 状态将变为真。开发者应在具体的 <code>@KafkaListener</code> 处理方法或 Service 层加入判断:<code>if (backpressureHandler.isBackpressured()) { return; }</code>。这种基于状态的开关控制,比试图捕获不存在的“积压异常”更为可靠且符合响应式系统的最佳实践。</p>
<h2>为什么全局异常处理器对积压无效</h2>
<p>全局异常处理器(如 <code>@RestControllerAdvice</code>)仅能捕获控制器层或业务层抛出的 <code>Throwable</code> 子类实例。消息队列的消费者通常运行在独立的线程池中,由中间件客户端库驱动。当消息堆积时,客户端库并不会抛出异常,而是继续从拉取接口获取消息,或者因内存不足导致 OOM。因此,任何试图在 <code>@ExceptionHandler</code> 中拦截“积压”的做法都是无效的,因为根本不存在对应的异常对象。唯一的解决方案是外部监控与内部状态机相结合。</p></topicpartition>


