






在java中利用hashset提升缓存性能的核心做法是将其作为去重和快速查找的底层数据结构,通过o(1)的时间复杂度替代线性搜索。具体实现时,需确保存入对象的equals()和hashcode()方法逻辑一致且稳定,并在初始化时根据预估数据量设置合适的初始容量以避免频繁扩容。这样做能显著减少内存占用并提高检索效率,但需注意若对象状态可变导致哈希值改变,会引发查找失败等严重问题。

如何正确实现自定义对象的哈希与相等判断
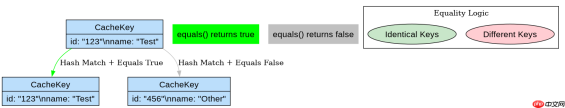
必须重写equals()和hashCode()方法以保证HashSet内部机制正常工作。这两个方法必须遵循契约:如果两个对象通过equals()比较返回true,那么它们的hashCode()必须相同。在实际编码中,通常使用IDE自动生成或java.util.Objects工具类来完成这一工作,确保基于业务关键字段(如ID、名称)进行计算。
import java.util.HashSet;
import java.util.Objects;

public class CacheKey {
    private final String id;
    private final String name;

    public CacheKey(String id, String name) {
        this.id = id;
        this.name = name;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        CacheKey cacheKey = (CacheKey) o;
        return Objects.equals(id, cacheKey.id) &&
               Objects.equals(name, cacheKey.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(id, name);
    }
}
上述代码展示了标准的实现方式。当向HashSet添加实例时,集合首先调用hashCode()确定桶位置,若存在冲突则调用equals()逐一比对。只有当两者都匹配时才视为重复元素不加入。这种机制依赖于方法的正确性,任何偏差都会导致缓存命中率下降或内存泄漏。
如何优化HashSet的容量与负载因子
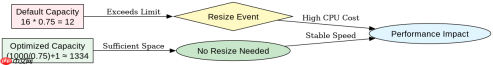
合理设置初始容量和负载因子可以减少哈希表的扩容次数,从而提升性能。默认情况下,HashSet的初始容量为16,负载因子为0.75。当元素数量超过容量乘以负载因子时,底层数组会扩容并重新哈希,这是一个耗时操作。在已知数据规模的情况下,应显式指定初始容量,公式通常为预期元素数 / 负载因子 + 1。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import java.util.HashSet;
import java.util.Set;

public class OptimizedCache {
    public static void main(String[] args) {
        // 假设预计有1000个唯一键
        int expectedSize = 1000;
        float loadFactor = 0.75f;

        // 计算最佳初始容量,避免多次扩容
        int initialCapacity = (int) (expectedSize / loadFactor) + 1;

        Set<string> cacheSet = new HashSet(initialCapacity, loadFactor);

        for (int i = 0; i </string>
通过预分配空间,程序避免了在插入过程中因数组满而触发的复制和重哈希操作。这对于高并发或大数据量的缓存场景尤为重要,因为扩容不仅消耗CPU,还可能引起短暂的停顿。保持负载因子在合理范围(如0.75)能在空间利用率和查询速度之间取得平衡。
可变对象作为键会导致什么具体问题
将可变对象放入HashSet后,如果修改了参与hashCode()计算的字段,会导致该对象无法被正常检索,甚至造成内存泄漏。这是因为对象的哈希值在存入后已固定用于定位桶位,一旦哈希值改变,它就不再位于原来的桶中,contains()或remove()操作将返回false。虽然对象仍存在于集合中,但已失去引用路径,形成“孤儿”数据。
import java.util.HashSet;
import java.util.Set;

public class MutableKeyIssue {
    public static void main(String[] args) {
        Set<mutablekey> set = new HashSet();
        MutableKey key = new MutableKey(1, "A");

        set.add(key);
        System.out.println("Added: " + set.contains(key)); // true

        // 修改影响哈希值的字段
        key.setId(2);

        System.out.println("After modify contains: " + set.contains(key)); // false!
        System.out.println("Set size: " + set.size()); // 1, 但找不到

        set.remove(new MutableKey(1, "A")); // 尝试移除原始值,失败
        System.out.println("Remove original: " + set.size()); // 仍为1
    }
}

class MutableKey {
    private int id;
    private String name;

    public MutableKey(int id, String name) { this.id = id; this.name = name; }
    public void setId(int id) { this.id = id; }

    @Override
    public int hashCode() { return Integer.hashCode(id); }
    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof MutableKey)) return false;
        return id == ((MutableKey) o).id;
    }
}</mutablekey>
此示例清晰展示了可变性带来的陷阱。一旦setId被调用,对象在新状态下无法通过contains找到,也无法通过原状态移除。解决之道是使用不可变对象(如final字段)作为缓存键,或在修改前先从集合中移除,修改后再重新添加。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



