






synchronized 的自适应自旋机制是什么
java synchronized 中的自适应自旋(adaptive spinning)是指线程在尝试获取锁失败时,不会立即进入阻塞状态,而是根据当前系统的负载情况和历史自旋成功概率来决定自旋的次数。如果之前自旋成功过,系统会认为该锁竞争不激烈,允许线程多自旋几次;反之,如果自旋失败率高,则直接挂起线程以节省 cpu 资源。
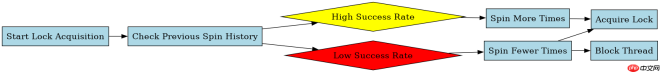
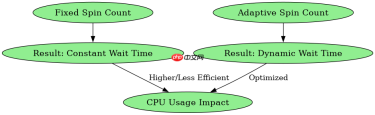
自适应自旋与固定自旋的区别及实现逻辑
自适应自旋的核心在于“自适应”,它通过记录上一次自旋的成功与否来动态调整下一次自旋的等待时间。相比之下,固定自旋无论环境如何都等待固定的次数。这种机制在 JDK 6 之后成为默认行为,旨在平衡 CPU 占用和锁获取延迟。

FilePond 灵活的 JavaScript 文件上传库
下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
public class AdaptiveSpinTest {
    private static Object lock = new Object();
    private static volatile boolean spinSuccess = false;

    public static void main(String[] args) {
        // 模拟第一次竞争,通常较短或无竞争
        Thread t1 = new Thread(() -> {
            synchronized (lock) {
                System.out.println("Thread-0 acquired lock");
                try { Thread.sleep(50); } catch (InterruptedException e) {}
            }
        });

        // 模拟第二次竞争,此时可能观察到自适应逻辑
        Thread t2 = new Thread(() -> {
            int spinCount = 0;
            while (!tryLock()) {
                spinCount++;
                // 模拟自旋
                if (spinCount > 100) break;
            }
            System.out.println("Thread-1 spun " + spinCount + " times");
        });

        t1.start();
        t2.start();
        try { t1.join(); t2.join(); } catch (InterruptedException e) {}
    }

    private static boolean tryLock() {
        // 伪代码:展示自旋逻辑
        // 实际 JVM 内部使用 CAS 和自旋循环
        return false; // 简化示意
    }
}
特定条件下自旋行为的验证
当多个线程同时竞争同一个锁对象时,自适应自旋会根据前一次线程获取锁的情况来决定当前的自旋策略。如果前一个持有锁的线程很快释放了锁,后续线程可能会选择自旋等待,因为锁很可能马上可用。如果前一个线程长时间持有锁,后续线程则会快速放弃自旋并进入阻塞状态。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


