






Switchover卡死时如何快速恢复主备角色
当oracle 19c执行switchover切换操作卡死时,应急处理的核心是立即终止当前会话并检查数据库状态,若确认原主库已不可用且新主库未正确提升,需手动强制启动原备库为读写模式以恢复业务。具体做法是首先通过alter database commit to switchover to physical standby with session shutdown命令尝试强制结束挂起的会话,如果该命令也超时或报错,则需在原主库服务器上直接关闭数据库实例(shutdown immediate),随后在原备库上执行alter database activate physical standby database将其激活为主库。此过程会丢失部分未传输的日志,但能确保服务尽快恢复。

如何验证切换后的数据一致性与归档状态
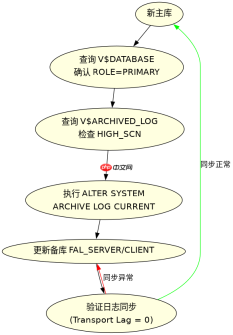
在成功完成强制切换后,必须验证新主库的数据一致性和归档日志状态,以确保没有数据丢失且后续复制链路正常。具体做法是在新主库上查询V$DATABASE和V$ARCHIVED_LOG视图,确认DATABASE_ROLE字段已变为PRIMARY,并检查HIGH_SCN与之前备库的CURRENT_SCN是否匹配。同时,需要在新主库上生成一个新的归档日志(ALTER SYSTEM ARCHIVE LOG CURRENT),以便后续的备库能够接收并开始同步。如果存在多个备库,需重新配置它们的FAL_SERVER和FAL_CLIENT参数指向新的主库。

管理常用模板和片段,按场景、角色、语气、长度切换并维护版本。;use for templates, snippets, writing workflows;do not use for 塞入未经审校的敏感话术, 替代版本管理系统.
基于V$DATAGUARD_STATS查看延迟原因的具体问题
如果在切换过程中发现备库应用日志严重滞后,导致切换时间过长甚至卡死,可以通过查询V$DATAGUARD_STATS视图来定位具体的延迟原因。该视图提供了详细的统计信息,包括transport lag、apply lag和estimated startup time等关键指标。通过观察这些指标,可以判断是网络传输问题还是备库IO性能瓶颈导致的延迟。例如,如果transport lag较大而apply lag较小,说明网络传输慢;反之,如果apply lag较大,则可能是备库CPU或IO资源不足。根据这些信息,可以调整LOG_ARCHIVE_DEST_2的参数,如增加并行度或优化网络带宽,以加快日志传输和应用速度。


