






在 sql server 2022 中,防止执行计划污染的核心做法是启用 optimize for unknown 提示或强制使用参数化查询,并配合 option (recompile) 仅在必要时使用。这能确保优化器基于统计信息生成通用且稳定的执行计划,而不是被特定参数的值误导。

如何识别和避免参数嗅探导致的执行计划缓存问题?
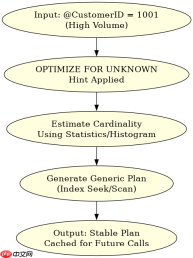
当存储过程或批处理首次编译时,SQL Server 会“嗅探”传入的实际参数值来生成执行计划。如果后续调用传入的值分布差异巨大(例如一次查少量数据,一次查大量数据),缓存的计划可能不再适用,导致性能下降甚至执行计划被频繁替换。解决此问题的标准做法是使用 OPTIMIZE FOR UNKNOWN,它告诉优化器忽略首次调用的具体值,转而使用列的平均密度或直方图统计信息来估算基数。
CREATE PROCEDURE GetOrdersByCustomer
    @CustomerID INT
AS
BEGIN
    SET NOCOUNT ON;

    SELECT o.OrderID, o.OrderDate, o.TotalAmount
    FROM Sales.Orders o
    INNER JOIN Sales.Customers c ON o.CustomerID = c.CustomerID
    WHERE c.CustomerID = @CustomerID
    OPTION (OPTIMIZE FOR UNKNOWN);
END;
上述代码中,OPTION (OPTIMIZE FOR UNKNOWN) 是关键。它强制优化器在编译阶段将 @CustomerID 视为未知值,从而选择一个对大多数情况都合理的索引扫描或查找策略,避免了因特定客户订单量极大或极小而生成的极端计划。运行该存储过程后,无论传入哪个 @CustomerID,只要统计信息准确,执行计划通常保持稳定。
在复杂JOIN场景下,如何平衡参数化与执行计划稳定性?
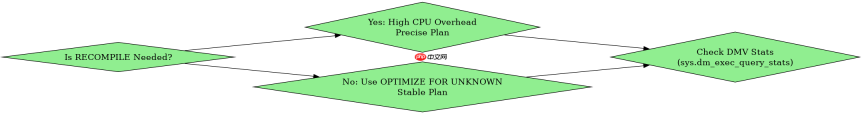
对于涉及多表 JOIN 的复杂查询,简单的参数化可能不足以解决所有问题。此时,可以结合 OPTION (RECOMPILE) 使用,但这会增加 CPU 开销。更推荐的做法是利用 SQL Server 2022 的增强功能,如智能查询处理中的自适应连接,或者通过调整统计信息的更新频率来改善基数估计。此外,使用局部变量赋值也是一种常见技巧,但需注意其局限性。
-- 方法一:使用局部变量(注意:可能导致次优计划)
DECLARE @LocalCustID INT = @CustomerID;
SELECT * FROM Orders WHERE CustomerID = @LocalCustID;

-- 方法二:强制重新编译(高CPU开销,但计划最精确)
SELECT * FROM Orders WHERE CustomerID = @CustomerID
OPTION (RECOMPILE);
在实际开发中,应优先测试 OPTIMIZE FOR UNKNOWN 的效果。如果某些特定查询仍然表现不佳,再考虑是否真的需要 RECOMPILE。可以通过 sys.dm_exec_query_stats 监控执行计划的重复使用率和平均执行时间,以评估当前策略的有效性。避免盲目使用 RECOMPILE,因为它会抵消缓存计划带来的性能优势。
当输入参数为空字符串时,JOIN条件如何处理?
在 SQL Server 中,如果传入的参数为空字符串('')或 NULL,JOIN 条件的行为取决于具体的比较逻辑。通常,空字符串不等于 NULL,也不等于其他非空值。因此,如果 WHERE 子句中包含 = @Param,且 @Param 为空,则不会匹配任何记录,除非表中确实存在空字符串值。为了避免这种情况,可以在查询中加入显式的 NULL 或空值检查。
SELECT * FROM Orders o
INNER JOIN Customers c ON o.CustomerID = c.CustomerID
WHERE (@CustomerID IS NULL OR @CustomerID = '' OR c.CustomerID = @CustomerID);
这段代码确保了当 @CustomerID 为空或 NULL 时,查询不会过滤掉所有数据,而是返回所有关联的客户订单。这是一种防御性编程实践,特别适用于前端传递可选筛选参数的场景。通过这种方式,可以保持执行计划的灵活性,同时正确处理边界条件。


