






如何在SQL中对变长文本内容计算分组哈希聚合校验码
使用数据库内置的字符串哈希函数配合聚合操作即可实现。以mysql为例,调用`group_concat()`将组内文本拼接后传入`sha2()`或`md5()`函数,并设置分隔符以避免歧义;postgresql则可直接对数组类型使用`array_agg()`结合`digest()`函数。这样做能生成固定长度的十六进制校验码,用于快速比对不同批次数据的完整性。

如何避免拼接顺序导致的哈希值不一致
必须确保聚合前的数据顺序一致,否则相同的集合会因排列不同产生不同的哈希值。在MySQL中,通过`ORDER BY`子句强制`GROUP_CONCAT`按特定字段排序;在PostgreSQL中,利用`array_agg`的排序选项或先进行子查询排序再聚合。这保证了无论底层存储顺序如何,最终生成的校验码都是确定性的。
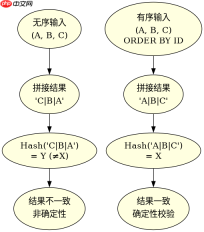
SELECT
  category,
  SHA2(GROUP_CONCAT(text_content ORDER BY id SEPARATOR '|'), 256) AS hash_code
FROM records
GROUP BY category;
如何处理空值或NULL输入对校验码的影响
默认情况下,聚合函数通常会忽略NULL值,但这可能导致校验码无法反映数据缺失的情况。若需将NULL视为特定字符(如空字符串)参与计算,应先用`COALESCE`或`IFNULL`将其替换为占位符。例如,将NULL转为空字符串`''`,这样在拼接时就会包含该位置的空值标记,从而改变最终的哈希结果,确保校验码能敏感捕捉到数据内容的细微变化。
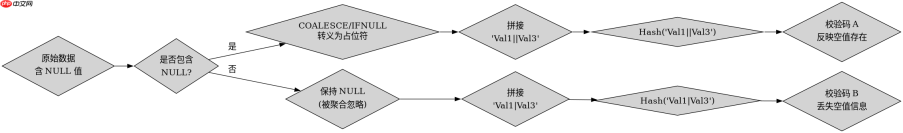
SELECT
  category,
  MD5(GROUP_CONCAT(IFNULL(text_content, 'NULL_PLACEHOLDER') ORDER BY id)) AS robust_hash
FROM records
GROUP BY category;


