






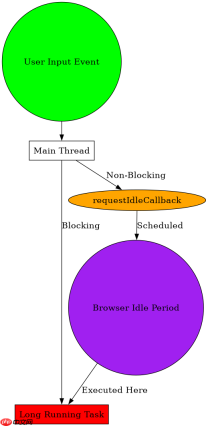
使用 requestidlecallback 将非关键任务推迟到浏览器空闲时执行,从而避免阻塞主线程导致输入延迟。通过检查 requestidlecallback 的可用性并设置超时 fallback,可以在支持该 api 的环境中优先利用空闲时间处理低优先级逻辑,确保用户交互得到即时响应。

requestIdleCallback 如何调度任务
该 API 允许开发者指定一个回调函数,在浏览器完成绘制和用户交互后的空闲时段运行。它接收两个参数:回调函数和可选的配置对象,其中 timeout 用于强制在指定毫秒后执行,防止任务被无限期挂起。这种机制确保了高优先级的输入事件(如点击、键盘输入)不会被后台任务抢占 CPU 资源。
if (typeof requestIdleCallback !== 'undefined') {
  requestIdleCallback(handleLongTask, { timeout: 2000 });
} else {
  setTimeout(handleLongTask, 1);
}
上述代码展示了核心实现逻辑。首先检测全局环境是否支持 requestIdleCallback。如果支持,则调用该方法并将耗时操作 handleLongTask 放入空闲队列,同时设置 2000 毫秒的超时时间作为安全网。如果不支持(如在旧版浏览器中),则降级使用 setTimeout 并设置极短的延迟,虽然这不能保证在“空闲”时执行,但至少能避免同步阻塞主线程,给予浏览器处理 UI 更新的机会。
长任务对输入延迟的具体影响
当 JavaScript 在主线程上执行长时间运行的脚本时,浏览器无法响应用户的输入事件,导致明显的卡顿感。这种延迟通常表现为输入框字符出现滞后或按钮点击无反应。通过将计算密集型任务拆分或使用 Web Workers,可以显著降低主线程的负载,但 requestIdleCallback 提供了一种更轻量级的解决方案,特别适用于数据预处理、日志记录或非紧急的状态更新等场景。


function processUserData(data) {
  // 模拟耗时操作
  const result = data.map(item => item * 2);
  console.log('Processed:', result);
}

// 假设这是从服务器获取的大量数据
const largeDataset = Array.from({ length: 10000 }, (_, i) => i);

requestIdleCallback(() => {
  processUserData(largeDataset);
}, { timeout: 5000 });
在这个示例中,我们创建了一个包含 10000 个元素的大数组,并对每个元素进行乘法运算。这个操作如果在主线程同步执行,可能会占用数十毫秒,足以造成可见的输入延迟。通过将其包裹在 requestIdleCallback 中,我们告诉浏览器:只要有机会,就请执行这个任务。如果用户在 5000 毫秒内没有触发任何需要立即响应的操作,或者浏览器进入空闲状态,任务就会执行。如果超时,任务也会强制执行,以保证数据最终能被处理。
基于超时参数的具体行为验证
当 requestIdleCallback 的 timeout 参数被设置且时间到达时,即使浏览器仍处于忙碌状态,回调函数也会被强制执行。这一特性对于确保关键业务逻辑不会因页面长期无空闲而永远得不到处理至关重要。在实际开发中,应根据任务的紧急程度合理设置超时值,平衡用户体验与任务执行的及时性。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





