






trace 级别在 Java 日志中什么时候用
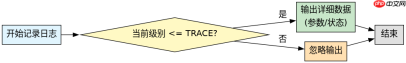
当需要记录方法执行过程中的极细粒度数据(如入参、出参、循环变量或中间状态)以辅助排查复杂逻辑问题时使用 trace 级别。具体做法是在代码的关键计算节点调用 logger.trace(),并传入具体的变量值或对象快照。这样做会在控制台或日志文件中输出详细的数据流信息,帮助开发者还原程序运行时的真实上下文。需要注意的是,由于 trace 日志会产生大量输出,通常仅在开发环境或特定问题的调试阶段开启,生产环境中默认关闭以避免性能损耗。
如何配置日志框架以启用 trace 级别
要查看 trace 级别的日志,需要在项目的配置文件中将对应包或根日志的级别设置为 TRACE。对于 Spring Boot 项目,通常在 application.yml 或 application.properties 中进行配置。例如,将 logging.level.root 设为 TRACE 可以开启全局追踪,或者针对特定包如 com.example.demo 单独开启。配置生效后,应用启动时日志框架会加载该设置,使得低于 INFO 级别的 DEBUG 和 TRACE 消息能够被输出到控制台或文件。
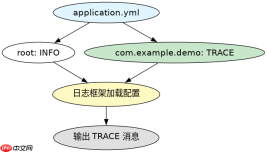

logging:
  level:
    root: INFO
    com.example.demo: TRACE
如何避免 trace 日志中的字符串拼接开销
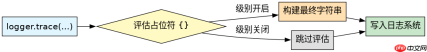
在使用 trace 级别记录复杂对象或动态生成的字符串时,必须使用占位符语法或条件判断来避免不必要的性能开销。如果直接通过字符串拼接方式记录日志,即使日志级别被过滤,拼接操作本身仍会执行,导致 CPU 和内存浪费。正确的做法是使用 SLF4J 提供的占位符 {},或者在调用前检查日志级别是否开启。这样只有当 trace 级别实际生效时,才会执行昂贵的对象序列化或字符串构建操作。
// 错误写法:无论是否开启 trace,都会执行 toString()
logger.trace("User details: " + user.toString());

// 正确写法:仅当 trace 开启时才执行 toString()
logger.trace("User details: {}", user);
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


