






java 日志记录中实现日志采样,核心做法是借助 slf4j 提供的 mdc(mapped diagnostic context)或 threadlocal 机制,在请求入口处生成一个唯一的 traceid 并放入上下文,随后通过自定义的 logback appender 或 filter 拦截日志事件,利用该 id 结合随机数判断是否丢弃当前日志。这样做可以在高并发场景下显著降低 i/o 开销和存储压力,同时保留部分关键日志用于链路追踪和问题排查。

如何在代码中注入并传递 TraceId
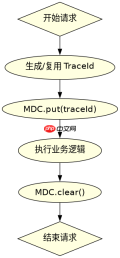
要在 Java 应用中实现采样,第一步是在请求处理的入口(如 Servlet Filter、Spring Interceptor 或 Dubbo Filter)生成一个全局唯一的标识符,通常称为 TraceId。这个 ID 需要被存入 MDC 中,因为大多数主流日志框架(如 Logback)默认支持从 MDC 读取变量并写入日志文件。MDC 基于 ThreadLocal 实现,能确保在同一线程内不同层级的代码都能访问到同一个 TraceId,从而实现跨模块的链路关联。
import org.slf4j.MDC;
import java.util.UUID;

public class TraceFilter {
    public void doFilter() {
        // 1. 生成唯一ID
        String traceId = UUID.randomUUID().toString().replace("-", "");
        // 2. 放入MDC
        MDC.put("traceId", traceId);
        try {
            // 执行业务逻辑
            processRequest();
        } finally {
            // 3. 清理资源,防止内存泄漏
            MDC.clear();
        }
    }
}
上述代码展示了最基础的注入方式。在实际生产环境中,如果上游已经传入了 TraceId(例如来自网关),应优先复用上游 ID 以保持链路连续性;若无上游 ID,则生成新的。关键点在于 finally 块中的 MDC.clear(),这能有效避免线程池复用导致的上下文污染。一旦 TraceId 进入 MDC,后续的日志调用如 logger.info("Processing...") 都会在输出中自动包含该 ID,前提是日志配置文件正确配置了 PatternLayout。

如何配置 Logback 实现基于概率的采样过滤
仅仅有 TraceId 是不够的,采样逻辑必须发生在日志输出的环节。Logback 提供了 LevelFilter、ThresholdFilter 等内置过滤器,但原生并不直接支持“按百分比采样”。因此,我们需要编写一个自定义的 Filter 类来实现概率判断。这个过滤器会继承 ch.qos.logback.classic.filter.ThresholdFilter 或直接实现 Filter 接口,在 decide 方法中获取当前的日志级别和 MDC 中的 TraceId,然后生成一个随机数来决定是否接受该日志事件。

SamplingFilter
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


