






在java中处理读多写少场景,首选 copyonwritearraylist。它通过读写分离机制,在写入时复制底层数组并加锁,读取时直接访问旧数组且无需同步,从而极大提升并发读取性能。若数据量较小且对实时性要求不高,这是最稳妥的选择;若数据量巨大或内存敏感,则需考虑使用 concurrenthashmap 配合不可变对象,或基于版本号的手动乐观锁方案。
为什么普通 ArrayList 不适合高并发读多写少
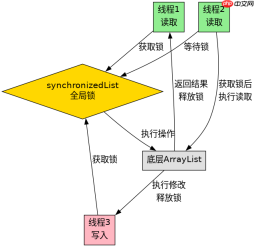
普通 ArrayList 是非线程安全的,在高并发环境下进行读取和写入操作会引发 ConcurrentModificationException 或数据不一致。即使外部使用 Collections.synchronizedList 包装,其内部实现也是对所有方法加全局锁,导致读写互斥,无法发挥“读多”的优势,吞吐量极低。
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

public class UnsafeArrayListDemo {
    public static void main(String[] args) {
        // 使用同步包装的 ArrayList
        List<string> list = Collections.synchronizedList(new ArrayList());
        list.add("initial");

        ExecutorService executor = Executors.newFixedThreadPool(10);

        // 模拟大量读操作
        for (int i = 0; i  {
                try {
                    Thread.sleep(10);
                    // 读取操作需要获取全局锁,与写操作互斥
                    String val = list.get(0);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            });
        }

        // 模拟少量写操作
        for (int i = 0; i  {
                synchronized (list) {
                    list.add("write-" + index);
                }
            });
        }

        executor.shutdown();
    }
}</string>
上述代码展示了使用 Collections.synchronizedList 的情况。虽然避免了异常,但每次 get 和 add 都需要竞争同一把锁。在读多写少的场景下,大量的读请求会阻塞少量的写请求,或者反之,导致整体吞吐量下降,违背了优化读取性能的初衷。
CopyOnWriteArrayList 的实现原理与适用边界
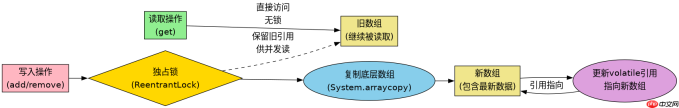
CopyOnWriteArrayList 的核心思想是“读写分离”。它内部维护一个 volatile 数组。读取操作直接访问该数组,不加任何锁,因此支持无限并发的读取。写入操作(如 add, remove)则会先获取一把独占锁(ReentrantLock),然后复制当前数组,在新数组上进行修改,最后将 volatile 引用指向新数组。这种设计保证了读取的高性能,但带来了两个主要代价:一是内存占用翻倍(新旧数组同时存在),二是数据一致性仅为“最终一致性”,即读取者可能读到旧数据。

import java.util.concurrent.CopyOnWriteArrayList;
import java.util.concurrent.CountDownLatch;

public class COWALDemo {
    public static void main(String[] args) throws InterruptedException {
        CopyOnWriteArrayList<string> list = new CopyOnWriteArrayList();
        list.add("A");
        list.add("B");

        CountDownLatch latch = new CountDownLatch(1);
        int threadCount = 10;

        // 启动多个读取线程
        for (int i = 0; i  {
                try {
                    latch.await(); // 等待开始信号
                    for (int j = 0; j <p>运行上述代码,可以看到在写入发生时,读取线程依然能正常访问旧数组中的数据,不会抛出异常,也不会被阻塞。当写入完成后,新的读取操作会自动获取到新数组的数据。这种机制非常适合配置列表、黑名单等变更频率极低且读取频繁的场景。但如果写入非常频繁,频繁的数组复制会导致严重的 GC 压力和 CPU 开销,此时应慎用。</p>
<h2>当数据量极大时如何权衡内存与一致性</h2>
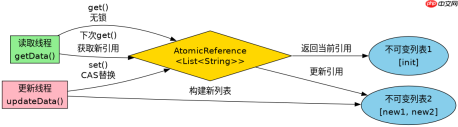
<p>如果集合中的数据量非常大(例如百万级元素),<code>CopyOnWriteArrayList</code> 的数组复制机制会导致巨大的内存开销和停顿时间。此时,可以考虑使用 <code>ConcurrentHashMap</code> 存储不可变对象,或者使用带有版本号的自定义结构。另一种常见做法是使用 <code>AtomicReference</code> 包裹一个不可变的 <code>List</code>(如 <code>Arrays.asList</code> 或 <code>Collections.unmodifiableList</code>)。更新时创建新的不可变列表并原子替换引用,读取时直接获取引用。这种方式同样实现了读写分离,但避免了部分复制,适合超大数据集。</p>
<pre class="brush:php;toolbar:false;">import java.util.Arrays;
import java.util.Collections;
import java.util.List;
import java.util.concurrent.atomic.AtomicReference;

public class AtomicListRefDemo {
    private AtomicReference<list>> dataRef = new AtomicReference(
        Collections.unmodifiableList(Arrays.asList("init"))
    );

    public List<string> getData() {
        return dataRef.get();
    }

    public void updateData(List<string> newData) {
        // 创建新的不可变列表
        List<string> immutableNewData = Collections.unmodifiableList(newData);
        // 原子替换引用
        dataRef.set(immutableNewData);
    }

    public static void main(String[] args) {
        AtomicListRefDemo demo = new AtomicListRefDemo();
        // 读取
        List<string> current = demo.getData();
        // 更新
        demo.updateData(Arrays.asList("new1", "new2"));
    }
}</string></string></string></string></list>
这种方案利用了 AtomicReference 的 CAS 操作保证引用的原子性,读取时无锁,写入时仅涉及一次引用赋值(前提是构建新列表的成本可控)。它牺牲了部分写入时的即时可见性(取决于构建新列表的时间),但极大地降低了内存压力,适合超大规模数据的读多写少场景。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


