






java hashmap 允许 null 键和 null 值,是因为其底层实现将 null 作为一个特殊的桶索引处理,而不是像其他集合那样直接抛出异常。具体做法是在 `put` 和 `get` 方法中增加对 null 的显式判断,将其固定存储在数组下标为 0 的位置,从而简化了调用方的空值检查逻辑。

HashMap 如何处理 null 键
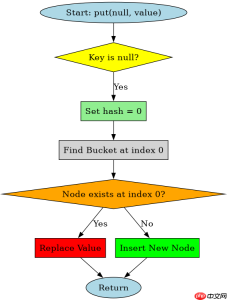
在 HashMap 中,null 键被允许且只能存在一个。当插入 null 键时,HashMap 不会计算其哈希值,而是直接定位到哈希表的第一个桶(即索引 0)。如果该位置已有节点,则覆盖;如果没有,则新建节点存入。这种设计避免了因调用 `hashCode()` 而可能引发的 NullPointerException,同时也让开发者在处理可选数据时更加便捷。
import java.util.HashMap;

public class NullKeyDemo {
    public static void main(String[] args) {
        HashMap<string integer> map = new HashMap();
        map.put(null, 1);
        System.out.println(map.get(null)); // 输出 1
        map.put(null, 2);
        System.out.println(map.get(null)); // 输出 2,旧值被覆盖
    }
}</string>
HashMap 如何处理 null 值
对于 null 值,HashMap 的处理方式与常规对象类似,但同样排除了哈希计算的步骤。当值为 null 时,它会被视为普通元素存入对应的桶中。由于 null 没有 hashCode,HashMap 在查找 null 值时,会遍历链表或红黑树,通过比较键是否相等来定位节点,并返回对应的 null 值。这使得 HashMap 可以明确区分“键不存在”和“键存在但值为 null”两种状态。


import java.util.HashMap;

public class NullValueDemo {
    public static void main(String[] args) {
        HashMap<string string> map = new HashMap();
        map.put("key", null);
        System.out.println(map.containsKey("key")); // true
        System.out.println(map.get("key"));         // null
        System.out.println(map.get("missing"));     // null,表示不存在
    }
}</string>
基于 put 方法源码的具体执行流程
在 `put` 方法的源码中,首先会检查 key 是否为 null。如果是 null,则调用 `putVal` 并将 hash 参数设为 0,直接定位到 table[0]。如果不是 null,则调用 `hash(key)` 计算哈希值。这一分支逻辑确保了 null 键始终位于数组头部,而其他键则根据哈希值分散存储。这种设计既保证了性能,又维持了 API 的一致性。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


