






将数据库查询结果映射到 hashmap 的核心做法是遍历 resultset,利用 getstring() 或 getobject() 获取列值,并以指定列名作为键存入 map。通常使用 while(rs.next()) 循环逐行处理,将每一行的数据转换为一个 map 对象并加入列表,或者根据业务需求将某列作为 key、另一列作为 value 直接构建单个 map。若存在主键冲突需覆盖旧值,则直接调用 map.put(key, value);若需保留所有记录,应使用 list 结构。

如何将 ResultSet 中的单行数据转为 Map
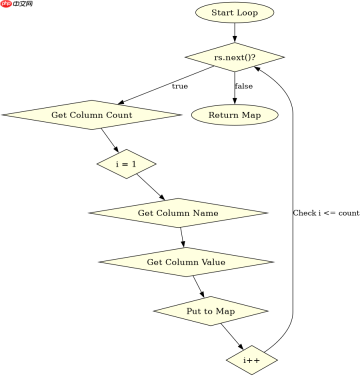
对于单行数据的转换,关键在于通过 ResultSetMetaData 获取列名,并在循环中动态绑定值。这种方式不依赖硬编码的字段索引,能自动适配 SQL 查询返回的列顺序和名称。执行时,先获取元数据确定列数,再在 while 循环内依次读取每列的值并存入新的 HashMap 实例中。
import java.sql.*;
import java.util.*;

public class ResultSetMapper {
    public static Map<string object> mapRow(ResultSet rs) throws SQLException {
        ResultSetMetaData metaData = rs.getMetaData();
        int columnCount = metaData.getColumnCount();
        Map<string object> rowMap = new HashMap();

        for (int i = 1; i  result = mapRow(rs);
        // System.out.println(result);
    }
}</string></string>
如何批量映射多行数据并处理重复键
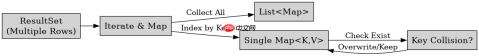
批量映射时,通常需要将每一行都转换为 Map 后存入 List,因为数据库查询往往返回多行。如果业务逻辑要求以某一列(如 ID)为 Key 构建单一 HashMap,则必须处理键冲突问题。默认情况下,put 操作会覆盖已有键的值。若需自定义冲突策略(如保留第一条或合并),可使用 computeIfAbsent 或 merge 方法。以下代码展示了如何将多行结果映射为 List,这是最通用的持久层返回格式。

import java.sql.*;
import java.util.*;

public class BatchResultSetMapper {
    public static List<map object>> mapAllRows(ResultSet rs) throws SQLException {
        List<map object>> results = new ArrayList();
        while (rs.next()) {
            // 复用上面的单行映射逻辑
            results.add(mapRow(rs));
        }
        return results;
    }

    // 示例:以 'id' 为键构建唯一 Map,后者覆盖前者
    public static Map<string object> buildKeyedMap(ResultSet rs) throws SQLException {
        Map<string object> keyedMap = new HashMap();
        while (rs.next()) {
            String id = rs.getString("id");
            if (id != null) {
                // 简单覆盖策略
                keyedMap.put(id, rs.getObject("value"));
            }
        }
        return keyedMap;
    }
}</string></string></map></map>
当 ResultSet 包含 NULL 值时 Map 的行为是什么
当数据库查询结果中包含 NULL 值时,rs.getObject(columnName) 会返回 Java 的 null 引用。此时将其放入 HashMap 是完全合法的,Map 中会存在一个值为 null 的条目。这不会抛出异常,但在后续取值时需进行空指针检查。若希望将数据库 NULL 转换为特定默认值(如空字符串或 0),需在存入 Map 前显式判断 rs.wasNull() 或使用 rs.getString() 配合三元运算符处理。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


