






java中执行批量数据转换的核心做法是使用 preparedstatement 的 addbatch() 和 executebatch() 方法。具体操作是:先通过 connection 创建预编译语句,在循环中设置参数并调用 addbatch() 累积数据,最后调用 executebatch() 一次性提交给数据库执行。这样做可以显著减少网络往返次数,提高大批量数据的插入或更新效率。

如何配置连接以支持高效批量处理
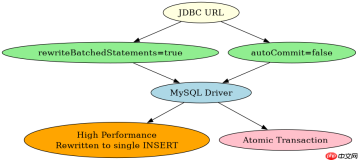
要使批量处理生效,必须在建立数据库连接时配置特定的 URL 参数,否则 executeBatch() 可能不会按预期工作。对于 MySQL 驱动,需要设置 rewriteBatchedStatements=true,这允许驱动程序将多个 INSERT 语句重写为一条包含多个值列表的 SQL 语句,从而大幅提升性能。此外,通常还需要关闭自动提交(autoCommit=false),以确保所有批次数据作为一个事务原子性地提交,避免部分成功部分失败导致的数据不一致。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchInsertExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb?rewriteBatchedStatements=true";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 关闭自动提交
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i <p>上述代码展示了完整的流程:首先获取连接并禁用自动提交,然后创建 <code>PreparedStatement</code>。在循环中,每次设置完参数后调用 <code>addBatch()</code> 将当前行加入队列。循环结束后,调用 <code>executeBatch()</code> 发送所有累积的数据。如果执行过程中出现异常,通过 <code>conn.rollback()</code> 回滚整个事务,保证数据完整性。最后打印出受影响的行数,即 <code>results</code> 数组的长度。</p><h2>如何处理批量执行中的异常与分批策略</h2><p>当批量数据量非常大时,一次性将所有数据放入内存可能导致 <code>OutOfMemoryError</code>,或者单个批次中包含错误数据导致整个批次回滚。因此,采用分批策略(Chunking)是必要的。可以将大数据集分割成固定大小(如 500 或 1000 条)的小批次,每批独立执行并提交。如果在某一批次中发生异常,仅该批次受影响,其他批次可以继续处理。同时,<code>executeBatch()</code> 返回的 <code>int[]</code> 数组包含了每个语句的执行结果,其中 <code>SUCCESS_NO_INFO</code> (-2) 表示成功但无法确定影响行数,<code>EXECUTE_FAILED</code> (-3) 表示失败,可以通过检查这个数组来定位具体的失败项。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13407" title="Java基础版"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20d79f23518.jpg" alt="Java基础版" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13407" title="Java基础版" class="overflowclass">Java基础版</a>
													<p class="overflowclass">编写健壮 Java 代码的基础能力,覆盖空指针防护、相等性判断与基础异常处理。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13407" title="Java基础版" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p><img src="https://img.php.cn/upload/article/001/242/473/179505932221119.png?x-oss-process=image/resize,p_40" alt="Java PreparedStatement 怎么执行批量数据转换"></p><pre class="brush:php;toolbar:false;">import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.ArrayList;
import java.util.List;

public class ChunkedBatchExample {
    private static final int BATCH_SIZE = 500;

    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb?rewriteBatchedStatements=true";
        String user = "root";
        String password = "password";

        List<string> names = generateLargeDataset(2500); // 模拟2500条数据

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";

            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i  generateLargeDataset(int size) {
        List<string> list = new ArrayList();
        for (int i = 0; i <p>这段代码引入了分批逻辑。它定义了一个常量 <code>BATCH_SIZE</code> 为 500。在主循环中,每添加 500 条数据到批次后,就调用 <code>executeAndCheck</code> 方法执行当前批次并检查结果。如果任何一项返回 <code>EXECUTE_FAILED</code>,则抛出异常。执行成功后,调用 <code>pstmt.clearBatch()</code> 清空内部缓冲区,释放内存。循环结束后,检查是否还有剩余数据未执行,若有则再次执行。这种策略确保了即使有少量数据出错,也不会阻塞整个大数据集的导入,提高了系统的鲁棒性。</p>
<h2>executeBatch返回值中不同状态码的具体含义是什么</h2>
<p><code>executeBatch()</code> 返回的 <code>int[]</code> 数组中的每个元素代表对应 SQL 语句的执行结果。常见的状态码包括:<code>0</code> 表示成功且影响了 0 行(例如更新条件不匹配);<code>>0</code> 表示成功且影响了指定数量的行;<code>-2</code> (<code>SUCCESS_NO_INFO</code>) 表示成功但无法确定影响行数(常见于某些数据库的批量插入);<code>-3</code> (<code>EXECUTE_FAILED</code>) 表示该语句执行失败。理解这些状态码有助于精确判断批量操作的每一步执行情况,特别是在需要记录日志或进行细粒度错误处理时。</p></string></string>
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


