






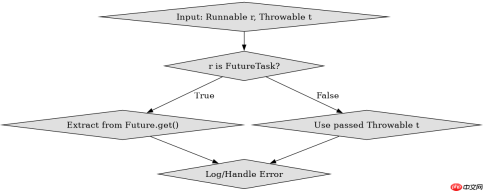
重写 afterexecute 处理异常,需要在自定义的 threadpoolexecutor 子类中覆盖该方法,并在方法体内检查 runnable 或 future 对象是否包含未捕获的异常。具体做法是判断任务是否为 futuretask 实例,如果是则调用其 get() 方法并捕获 executionexception;如果任务直接抛出异常(非 futuretask),则通过 throwable 参数获取异常信息。这样可以在任务执行完毕后统一收集错误日志或触发告警。

如何区分 FutureTask 和 Runnable 的异常来源
在 afterExecute 中,必须根据任务类型采用不同的异常提取策略。对于实现了 Future 接口的任务(通常是 FutureTask),异常被封装在 Future.get() 抛出的 ExecutionException 中;而对于普通的 Runnable,异常会直接作为第二个参数传入 afterExecute。这种差异是因为 FutureTask 内部捕获了异常并存储起来,而普通 Runnable 的异常由线程组或默认处理器处理,但在线程池回调中仍会被传递。

import java.util.concurrent.*;

public class CustomThreadPool extends ThreadPoolExecutor {
    public CustomThreadPool(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<runnable> workQueue) {
        super(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue);
    }

    @Override
    protected void afterExecute(Runnable r, Throwable t) {
        super.afterExecute(r, t);
        if (t == null && r instanceof Future>) {
            try {
                ((Future>) r).get();
            } catch (CancellationException ce) {
                t = ce;
            } catch (ExecutionException ee) {
                t = ee.getCause();
            } catch (InterruptedException ie) {
                Thread.currentThread().interrupt();
            }
        }
        if (t != null) {
            System.out.println("Task failed: " + t.getMessage());
        }
    }
}</runnable>
为什么需要调用 super.afterExecute
在重写 afterExecute 时,必须显式调用 super.afterExecute(r, t),否则将破坏线程池的内部状态维护机制。父类方法负责清理监控指标、更新统计信息以及处理某些特定的生命周期事件。如果省略这一步,虽然能捕获异常,但会导致线程池的监控数据不准确,且在某些高级功能(如 JMX 注册)上可能出现异常。此外,确保在捕获异常后不重新抛出,以免干扰线程池的正常调度流程。

import java.util.concurrent.*;

public class TestAfterExecute {
    public static void main(String[] args) {
        CustomThreadPool pool = new CustomThreadPool(1, 1, 0L, TimeUnit.SECONDS, new LinkedBlockingQueue());

        // 测试 FutureTask 异常
        pool.submit(() -> { throw new RuntimeException("Future Error"); });

        // 测试 Runnable 异常
        pool.execute(() -> { throw new RuntimeException("Runnable Error"); });

        pool.shutdown();
    }
}
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


