






为什么SQL多层嵌套视图会导致严重的查询性能恶化
sql多层嵌套视图导致性能恶化的核心原因是数据库优化器无法有效下推过滤条件,导致中间结果集在内存或磁盘中被全量计算和传递。当视图层层嵌套时,每一层都会生成一个临时的中间数据集,如果这些数据集没有经过有效的索引过滤,数据量会呈指数级膨胀,造成巨大的i/o开销和cpu资源浪费。
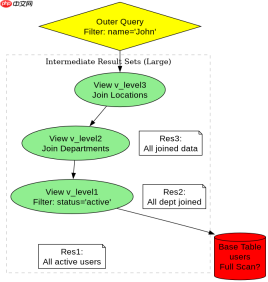
嵌套视图如何阻碍谓词下推与索引使用
在深层嵌套的视图中,优化器往往难以将最外层的WHERE条件下推到最内层的基表,导致基表的全表扫描。即使基表上有合适的索引,由于视图的逻辑复杂性(如聚合、连接),优化器可能选择忽略索引,转而使用临时表存储中间结果,进一步加剧性能问题。

-- 假设有一个三层嵌套视图:v_level3 -> v_level2 -> v_level1
-- 基表: users (有索引 idx_status)

CREATE VIEW v_level1 AS
SELECT id, name, status FROM users WHERE status = 'active';

CREATE VIEW v_level2 AS
SELECT id, name, department_id FROM v_level1 JOIN departments ON v_level1.department_id = departments.id;

CREATE VIEW v_level3 AS
SELECT id, name, dept_name FROM v_level2 JOIN locations ON v_level2.location_id = locations.id;

-- 查询最外层视图
SELECT * FROM v_level3 WHERE name = 'John';

-- 预期行为:应直接查询users表并应用所有过滤条件
-- 实际行为:可能先计算v_level1的所有active用户,再join departments,再join locations,最后过滤name='John'
基于具体输入条件的性能差异分析
当查询条件涉及非选择性字段或复杂逻辑时,性能恶化尤为明显。例如,如果最外层的过滤条件无法下推,中间结果集的大小将完全取决于基表的数据量,而不是最终需要的行数。这种“先扩大后缩小”的模式是性能瓶颈的主要来源。



