






在sql中排除特定异常值后执行avg聚合计算,最直接且通用的做法是使用条件表达式(如case when)结合过滤逻辑,或者利用窗口函数识别并剔除偏离均值或分位数的数据行。具体而言,可以通过子查询先计算出数据的统计阈值(例如均值加减两倍标准差,或上下四分位数),然后在主查询中仅保留符合正常范围的数据再进行avg运算;若需处理更复杂的离群点,可借助percentile_cont等分析函数动态确定边界。这种方法能确保参与平均计算的数值既不包含极端干扰项,又保留了业务上合理的波动范围。
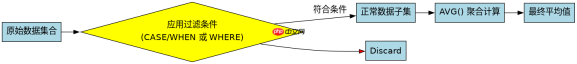
如何使用CASE WHEN过滤固定范围的异常值
使用CASE WHEN配合WHERE子句是处理已知异常区间最基础的方法。假设我们有一个订单表orders,其中amount字段偶尔会出现负数或超过10000的录入错误,我们可以直接在这些值被纳入聚合前将其排除。这种做法适用于异常值具有明确物理意义或业务规则限制的场景,例如金额不能为负。通过构建一个包含过滤条件的子查询,可以干净地隔离脏数据,保证后续AVG函数的输入纯净。
SELECT AVG(amount) AS clean_avg
FROM orders
WHERE amount > 0
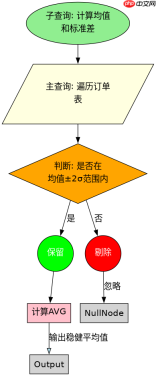
  AND amount <p>上述代码直接对orders表进行筛选。预期结果是:如果表中存在amount为-50或20000的记录,它们将被WHERE子句拦截,不参与AVG计算。最终返回的clean_avg仅基于0到10000之间的有效金额。这种方法的优点是逻辑简单直观,无需复杂统计知识,缺点是如果异常值的定义发生变化,需要手动修改SQL中的阈值。</p><h2>如何基于统计分布自动剔除离群点</h2><p>当异常值没有固定界限,而是表现为统计上的离群点时,可以使用标准差或分位数来动态界定正常范围。以标准差为例,通常认为落在均值±2倍标准差之外的数据为异常值。我们可以通过子查询先计算全表的均值和标准差,然后在主查询中比较每条记录是否处于该区间内。这种方法能自适应数据的变化,适合数据分布相对稳定的场景。需要注意的是,如果数据本身偏态严重,标准差方法可能不够准确,此时应优先考虑分位数方法。</p><p><img src="https://img.php.cn/upload/article/000/969/633/179505282734376.png?x-oss-process=image/resize,p_40" alt="如何在SQL中排除特定异常值后再执行AVG聚合计算"></p><pre class="brush:php;toolbar:false;">WITH stats AS (
    SELECT
        AVG(amount) AS mean_val,
        STDDEV(amount) AS std_val
    FROM orders
)
SELECT AVG(o.amount) AS robust_avg
FROM orders o, stats s
WHERE o.amount BETWEEN (s.mean_val - 2 * s.std_val)
                   AND (s.mean_val + 2 * s.std_val);
这段代码首先通过CTE(公共表表达式)stats计算出orders表的平均值mean_val和标准差std_val。接着在主查询中,将orders表与stats表进行交叉连接(隐式JOIN),并对每笔订单的金额进行判断。只有当金额落在[mean - 2*std, mean + 2*std]区间内时,才会被计入最终的AVG。预期结果是:即使数据中存在极端的极大或极小值,只要它们超出两个标准差的范围,就会被自动剔除,从而得到一个更具代表性的平均值。这种方法比固定阈值更灵活,但计算开销稍大,因为需要扫描两次数据(一次算统计量,一次做过滤)。
基于程序中某个输入、条件或结果的具体问题
在实际编程实现中,如果我们将上述SQL逻辑封装为应用程序中的一个函数,常见的具体问题是如何处理“所有数据均为异常值”或“标准差为零”的边界情况。例如,当某组数据的标准差为0(即所有值相同)时,均值±2倍标准差的区间退化为单点,此时若该点被视为异常(虽然逻辑上不应发生),可能导致结果为空。或者,当输入数据集中大部分值都是离群点时,过滤后可能剩余数据过少,导致AVG结果失真。针对这种情况,程序应在执行SQL前或解析结果后增加校验逻辑,例如检查过滤后的行数是否大于最小阈值,或者在标准差接近零时直接返回原始均值而非依赖区间过滤。


